NIST AI 600-1 memakai istilah confabulation untuk output generative AI yang keliru atau palsu tetapi disajikan yakin; cakupannya mencakup output yang menyimpang dari prompt atau bertentangan pernyataan sebelumnya dalam konteks sama. NIST menyebut hallucination atau fabrication sebagai istilah kolokial. Profil resiko ini menjadi landasan definisi halusinasi AI yang dapat diaudit, bukan label generik untuk setiap jawaban salah.
Tidak ada satu tingkat halusinasi universal. Angka hanya bermakna bersama task, kondisi input atau sumber, model dan versi, konfigurasi sampling, grader, numerator, denominator, perlakuan abstention, dan tanggal pengujian. Target praktis: kurangi confident unsupported claims, tingkatkan abstention atau klarifikasi yang tepat, dan cegah aksi atau klaim yang belum diverifikasi mencapai pengguna atau downstream system.
Jenis kegagalan dan incentive to guess
Wrong output tidak selalu halusinasi: model dapat faithfully mengulang sumber yang salah; failure locus berbeda. Taxonomy uji berorientasi referensi: world answer, supplied context, instruction, conversation state, tool atau system-of-record state, media asli. Fabricated citation, false-premise, self-contradiction, dan claimed-but-unperformed action butuh bukti berbeda.
Paper OpenAI/Georgia Tech 2025 (Why language models hallucinate) berargumen pretraining next-token prediction menimbulkan error pada low-frequency facts dan banyak evaluasi binary mendorong tebak daripada abstain; jangan salah kutip sebagai bukti semua deployment pasti mengarang. Tow Center menguji delapan AI search tools dengan 1.600 query berita; kolektif lebih dari 60% query dijawab tidak benar pada task citation/retrieval waktu uji, bukan rate universal semua AI.
Studi Communications Medicine 2025 (5.400 simulated clinical prompts, enam LLM): planted false detail diulang atau dielaborasi pada 50–82% output; mitigation prompt menurunkan mean sekitar 65,9% menjadi 44,2%; temperature 0 sekitar 66,5% tanpa perbaikan signifikan pada setup itu. Temuan klinis spesifik; jangan generalisasi ke semua aplikasi atau anggap temperature 0 sebagai fix universal.
Kontrak pengukuran dan membaca rate
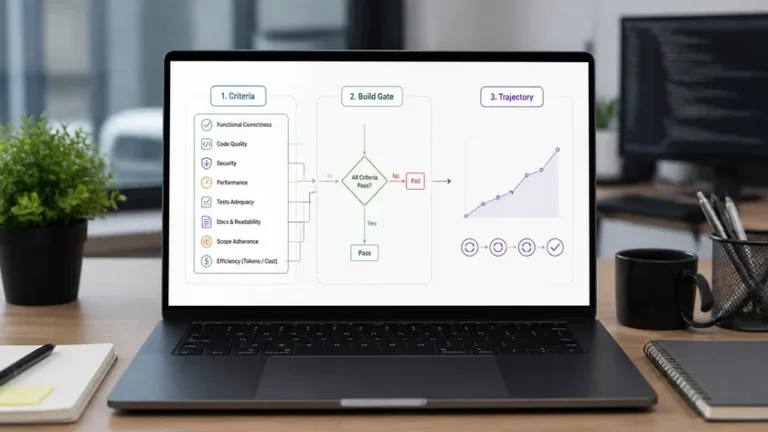
Template test auditable: use case dan harm; reference (canonical answer, dokumen, record DB, media asli); test set representative plus edge, unanswerable, false-premise, stale-source, multilingual, adversarial; exact system (model, retrieval index snapshot, prompt, tools, sampling, tanggal, runs); outcome taxonomy correct, wrong/unsupported, appropriate abstention, over-refusal, unable to verify; metrik wrong/all, wrong/answered, abstain/all, coverage, severity-weighted errors; regression setelah perubahan model, prompt, corpus, parser, tool, atau policy.
Jangan hanya melaporkan accuracy. Abstention menekan wrong answers tetapi dapat menaikkan over-refusal; laporkan coverage bersama error rate. Automated LLM judge dapat false positive/negative; high-stakes butuh audit sample dan human adjudication. RAG menambah sumber tanpa menjamin retrieval benar, mutakhir, atau generation faithful.
Kebijakan editorial Google menekankan fact-check manual sebelum publikasi konten berbasis AI, selaras dengan disiplin verifikasi klaim per klaim seperti di pemberitaan fact-check konten AI Google. Release gate agent: consequential action unverifiable tidak layak diubah jadi success hanya karena pesan agent terdengar meyakinkan.
Mitigasi berlapis sesuai sumber kegagalan
Retrieval dari sumber berotoritas plus freshness/provenance untuk fakta langka; allow abstention atau clarifying question dengan scoring yang menghukum confident error; constrained generation plus faithfulness check pada supplied context; resolve URL atau identifier dan cek passage mendukung claim; counterfactual regression untuk false-premise; independent read-back system of record untuk aksi agent; human review dan delayed execution pada output high-consequence; monitoring dan reassessment pasca deploy sesuai rekomendasi NIST GenAI risk management (NIST AI 600-1).
TestMu AI (framing vendor) memakai istilah hallucinated action bila agent melaporkan langkah selesai tanpa record atau tool effect; effectiveness independen harus dipisah dari terminologi produk. Tidak ada mitigation tunggal yang menghapus confabulation pada general-purpose system; jangan janji eliminate hallucinations.
CTA: bangun baseline 30–50 high-value cases milik Anda, termasuk pertanyaan yang semestinya ditolak; laporkan wrong, abstain, dan coverage terpisah. Sistem generatif baru dengan UI kompleks, seperti yang diuraikan dalam pembaruan GPT-6 di ChatGPT, menambah permukaan uji citation dan action verification di luar set benchmark lama.
Model leaderboard, hitungan kasus hukum, dan versi produk bersifat time-sensitive; snapshot tanggal wajib pada setiap angka benchmark spesifik model.