John Mueller, Search Advocate Google, berbicara di podcast Search Off the Record (1 Oktober 2026). Ia pernah melihat sitemap crawler AI mengakses file sitemap dan RSS di log server pribadinya.
Namun itu bukan bukti semua bot AI melakukan hal sama, dan bukan jaminan konten masuk indeks atau jawaban ChatGPT.
Search Engine Journal (6 Oktober 2026) merangkum episode «Do sitemaps still matter?»; sumber primer ada di Search Off the Record.
Mueller menegaskan sitemap tetap relevan untuk discovery; file llms.txt tidak menggantikan sitemap bagi Google Search.
Observasi Mueller: Log Sitemap, RSS, dan Crawler AI
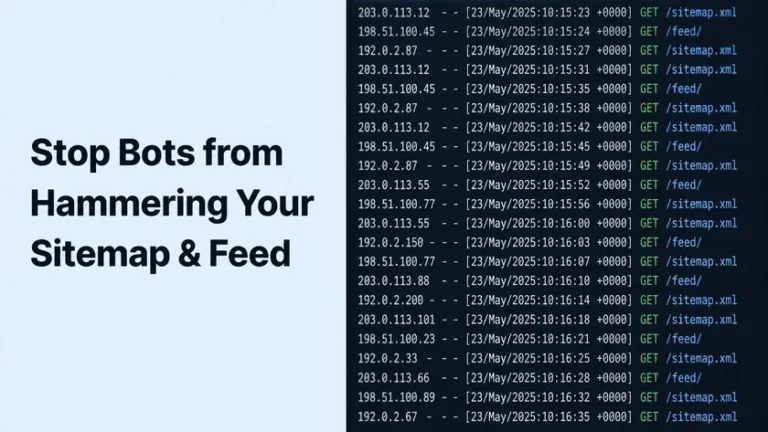
Meskipun log itu menarik, Mueller membedakan crawler pencarian, crawler training, retrieval AI, dan agent browser—istilah «AI crawler» bukan satu kategori homogen.
Observasinya hanya menunjukkan sebagian bot pernah fetch sitemap atau RSS. Mueller tidak menyebut vendor, frekuensi, atau apakah URL lalu masuk training, retrieval, atau citation.
Jadi discovery lewat sitemap/RSS mungkin terjadi. Itu tidak sama dengan indexing Google, ranking, atau visibility di produk AI pihak ketiga.
Apabila Anda mempertimbangkan memblokir bot tertentu, baca panduan haruskah block bot AI. Keputusan robots harus selaras kebijakan legal dan bisnis, bukan sekadar reaksi log. Ingat! hati-hati terkait block bot ini ya.
Sitemap, RSS, dan llms.txt untuk Google Search
Google Search Central menerima XML sitemap serta RSS 2.0, mRSS, dan Atom sebagai format sitemap.
RSS umumnya memuat konten terbaru; XML sitemap lebih fleksibel untuk kumpulan URL luas. Keduanya boleh hidup berdampingan.
Mueller menyarankan nama sitemap yang mudah dicari (contoh sitemap.xml) atau RSS bila pemilik situs ingin crawler tanpa Search Console tetap punya jalur discovery. Itu konvensi praktis, bukan syarat protokol.
Proposal komunitas llms.txt (llmstxt.org) punya struktur Markdown sendiri.
Tetapi Google Search Central (2026) menyatakan Google Search tidak membutuhkan file itu. Google tidak memprosesnya sebagai sitemap dan tidak mengubah ranking.
Anda boleh mempertahankan llms.txt untuk sistem lain bila dokumentasi provider mendukung.
Lantaran Google memakai protokol XML, Mueller menilai llms.txt tidak cukup «strict» untuk pipeline sitemap Google; analoginya mirip HTML sitemap: berguna navigasi, bukan pengganti XML sitemap protocol.
Selanjutnya, konteks lebih luas tentang peran llms.txt untuk agent ada di tutorial SEO untuk AI agent.
«Couldn’t Fetch» Sitemap dan Crawl Demand
Episode yang sama membahas Search Console yang menampilkan «Couldn’t fetch» meski sitemap valid di browser. Mueller menyebut host load dan crawl demand sebagai faktor, dan Google bisa menunda fetch bila kapasitas server terbatas atau sistem melihat kebutuhan crawl rendah.
Istilah «perceived quality» yang ia sebut terkait crawl demand, bukan skor publik tunggal.
«Couldn’t fetch» bukan diagnosis otomatis situs berkualitas rendah. Bisa juga URL salah, robots, gangguan sementara, atau antrean pemrosesan.
Kemudian, artikel sitemap website tidak sama dengan GSC membahas selisih jumlah URL dan kasus fetch gagal saat file terlihat OK.
Akhirnya, submit sitemap tetap hint, bukan janji crawl atau indexing penuh. Prioritas tetap URL canonical, internal link, dan konten yang layak untuk crawl.
Langkah Praktis Pemilik Website
Minimum konservatif: HTML crawlable, internal link kuat, XML sitemap akurat (URL canonical), RSS bila CMS menyediakan, robots.txt yang konsisten, dan monitoring Search Console. Tambah llms.txt hanya bila Anda punya alasan spesifik di luar Google Search—not sebagai pengganti sitemap.
Sebelum resubmit, tim WordPress yang sudah punya sitemap core atau plugin SEO sebaiknya memperbaiki akurasi URL dan lastmod yang jujur alih-alih mengulang submit tanpa perubahan.
Menurut kami, langkah itu lebih berguna daripada mengejar setiap bot AI di log server.
Tim CodeF membantu audit technical SEO dan maintenance sitemap bila fetch GSC atau struktur URL jadi bottleneck—bukan layanan «optimasi citation AI».