Google merilis episode Search Off the Record berjudul PDFs in Search: Indexing, AI & Pitfalls pada 13 Oktober 2026. Episode itu menjadi referensi utama bagi praktisi yang bertanya apakah PDF Google Search masih layak dipublish. Martin Splitt dan John Mueller dari tim Google Search Relations menjelaskan alur pemrosesan, indexing, dan peluang tampil di fitur pencarian generatif. Ini panduan teknis, bukan pengumuman algoritma baru yang mengubah ranking PDF khusus pada tanggal itu.
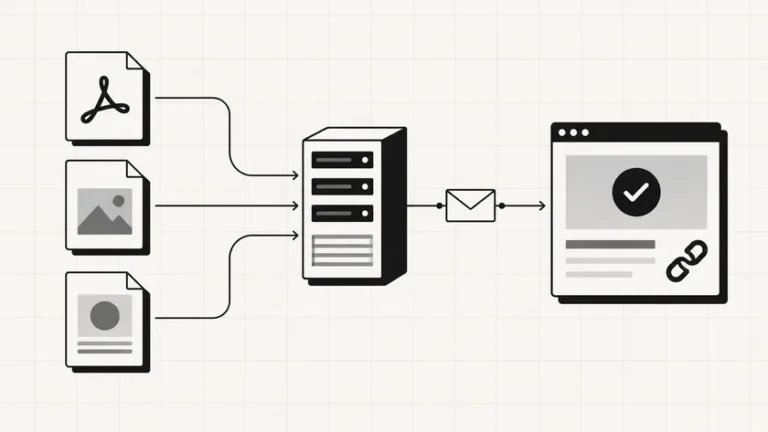
Inti jawaban Mueller dan Splitt: PDF bukan format terlarang. Google mengonversi isi PDF menjadi representasi mirip HTML agar sistem indexing yang sama dengan halaman web dapat menanganinya. PDF yang terindeks dapat ranking di Search biasa dan, bila memenuhi syarat, tampil di AI Overviews serta AI Mode. Namun keduanya menekankan HTML tetap format default yang mudah Anda update, responsif, dan accessible.
Konversi PDF Google Search dan ekstraksi link
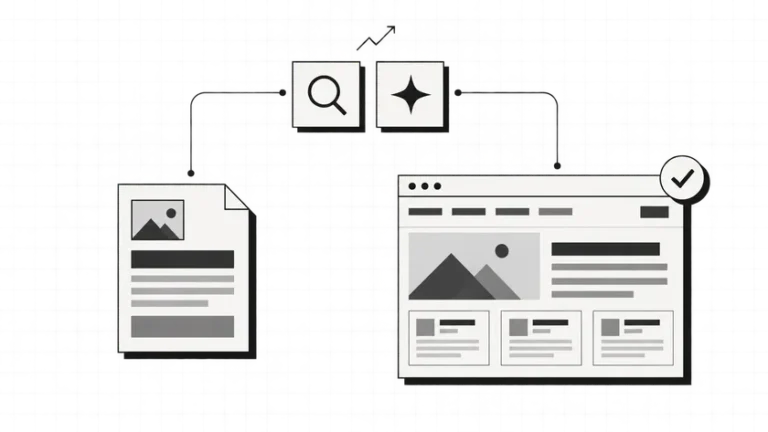
Google memperlakukan PDF sebagai kontainer biner, bukan teks polos seperti HTML. Komponen converter Google mengubah konten menjadi representasi HTML-like sebelum masuk pipeline indexing. Bot Google bisa merayap teks link embedded. Gambar di dalam PDF tidak selalu punya URL mandiri sehingga tidak otomatis masuk Google Images seperti asset web standar.
Ringkasan laporan Search Engine Roundtable (13 Oktober 2026) selaras dengan poin itu setelah peninjauan transkrip.
Mueller dan Splitt membahas batas ukuran crawl. Google sengaja tidak memfix angka cutoff publik lantaran Google menyesuaikan ambang seiring norma ukuran file. Praktisi kerap merujuk dokumentasi crawler Google (bukan kutipan langsung host podcast) untuk limit PDF lebih longgar dibanding halaman HTML. Sebelum mempublikasikan angka spesifik, verifikasi halaman dokumentasi resmi terbaru. Jangan menulis host podcast menyebut angka pasti bila transkrip tidak memuatnya.
Pitfall PDF pindai dan pembaruan lambat
PDF hasil scan atau halaman raster tanpa teks selectable sulit mesin baca tanpa OCR andal. Berikut uji praktis yang Mueller sebut: coba highlight, salin, dan tempel teks ke editor. Bila tidak ada teks nyata, jangan anggap indexing stabil.
PDF juga unduh penuh sebelum render di mobile. Layout cetak tidak reflow saat zoom. Screen reader bisa terhambat bila struktur accessibility lemah.
Google memperlakukan PDF relatif statis dan recrawl lebih jarang daripada HTML. Mueller menyarankan publikasi versi baru di URL atau nama file baru bila pembaruan cepat penting. Hindari menimpa blob biner yang sama. CMS yang otomatis menghasilkan PDF mirror dari halaman HTML dapat membuat dua versi bersaing di SERP. PDF mirror itu sering tertinggal outdated karena recrawl lambat.
Password protection memblokir bot. Metadata PDF, header canonical HTTP, dan link prominent kembali ke situs web membantu mengurangi masalah duplikasi antar domain ketika file biner identik.
AI Overviews dan rekomendasi format
Sistem AI Google bisa memakai konten PDF terindeks untuk grounding jawaban generatif. Visibilitas organik tetap paralel. Itu bukan “hack” ranking AI. Tetapi Mueller menolak framing bahwa PDF otomatis unggul dari HTML.
Untuk konten web-first yang sering berubah, butuh navigasi internal, atau interaksi rich, HTML lebih masuk akal. PDF tetap cocok untuk laporan unduh, formulir, brosur cetak, atau menu restoran kecil bila merawat HTML sulit. File seperti llms.txt sebaiknya tetap plain text, bukan PDF, karena tujuan formatnya ringan untuk konsumsi mesin.
Tim SEO yang mengelola arsitektur konten bisa memadukan panduan kapan sitemap HTML masih berguna dengan keputusan format publikasi. Selanjutnya, untuk risiko rendering client-side pada builder modern, lihat juga JavaScript SEO dan crawler AI.
Checklist praktis PDF Google Search sebelum publikasi
Pastikan Anda bisa menyalin teks, link penting berfungsi, nama file dan judul bermakna, serta ada alternatif HTML bila update rutin perlu. Bila angka ranking AI Overviews turun, validasi lewat Search Console dan query representatif. Jangan andalkan hanya asumsi format PDF.
Episode 13 Oktober 2026 memberi konteks teknis untuk audit dokumen legacy di situs WordPress atau company profile yang masih mengandalkan PDF laporan tahunan. Migrasi bertahap ke HTML untuk halaman yang sering perlu update tetap selaras dengan rekomendasi Splitt dan Mueller. PDF untuk use case unduhan resmi tetap boleh ada.
Mueller dan Splitt membahas debate menu restoran. PDF menu acceptable bila merawat HTML sulit, asalkan pengunjung mobile tidak terjebak unduh file besar. Mereka menekankan trade-off UX zoom dan accessibility dibanding halaman web responsif.
Untuk whitepaper B2B, kombinasi landing HTML ringkas plus PDF unduhan sering lebih jelas daripada hanya PDF di root domain. Landing HTML membawa internal link dan CTA. PDF memenuhi kebutuhan arsip offline.