Pesan Couldn’t fetch sitemap di Google Search Console artinya Google belum berhasil mengambil file sitemap saat laporan GSC terakhir diperbarui—bukan otomatis bukti XML rusak. Menurut John Mueller (podcast Search Off the Record, Oktober 2026), penyebabnya bisa keterbatasan host/crawl capacity atau Google sengaja tidak memprioritaskan fetch karena crawl demand rendah.
Martin Splitt mengangkat skenario familiar: sitemap valid, terbuka untuk publik, bahkan tercantum di robots.txt, tetap berstatus Couldn’t fetch. Wording GSC memang sering terdengar seperti error teknis padahal akar masalahnya lebih luas.
Highlight
Sitemap Valid tapi “Couldn’t Fetch” di Search Console: Penjelasan Google
- Couldn’t fetch ≠ XML invalid; pisahkan validitas, aksesibilitas, dan prioritas fetch Google.
- Host load / crawl capacity: Googlebot bisa menunda fetch agar tidak membebani host.
- Crawl demand: Google bisa melewatkan sitemap bila sudah cukup informasi crawl.
- Mueller: crawl demand sering terkait perceived quality—bukan verdict «situs jelek» per error.
- Sitemap tetap hint discovery; tidak menjamin crawl atau index setiap URL.
- Urutan audit: HTTP/XML/robots/WAF dulu; evaluasi demand/konten setelah teknis bersih.
Apa arti Couldn’t fetch sitemap di Search Console?
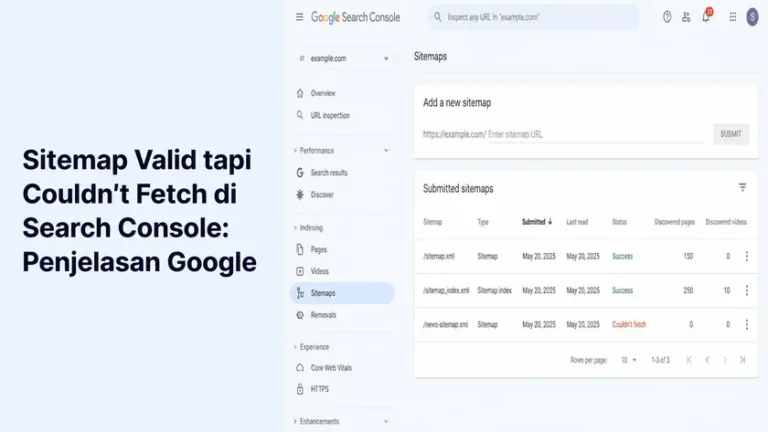
Search Console mencatat upaya Google mengambil URL sitemap yang Anda submit. Status Couldn’t fetch muncul bila fetch gagal atau tidak selesai pada siklus pelaporan—itulah laporan status, bukan diagnosa lengkap satu klik.
Mueller menekankan: file bisa benar secara format dan Google tetap belum fetch pada waktu tertentu. Jangan langsung anggap Search Console «bug»; lebih aman anggap label ini tidak selalu menjelaskan root cause.
Tiga lapisan terpisah: validitas XML, aksesibilitas untuk Googlebot, dan prioritas sistem Google memilih fetch sitemap saat itu. Browser Anda membuka sitemap.xml hanya membuktikan lapisan kedua sebagian—bukan jaminan Googlebot mendapat perlakuan identik (WAF, rate limit, geo, user-agent).
Host load dan crawl capacity: penyebab teknis
Salah satu penjelasan Mueller: Google mungkin tidak sempat fetch sitemap karena resource crawl pada host/site sedang Google pakai untuk URL lain. Ini terkait host load, serving capacity, dan batasan crawl capacity—not sekadar «hosting lemot» tanpa data.
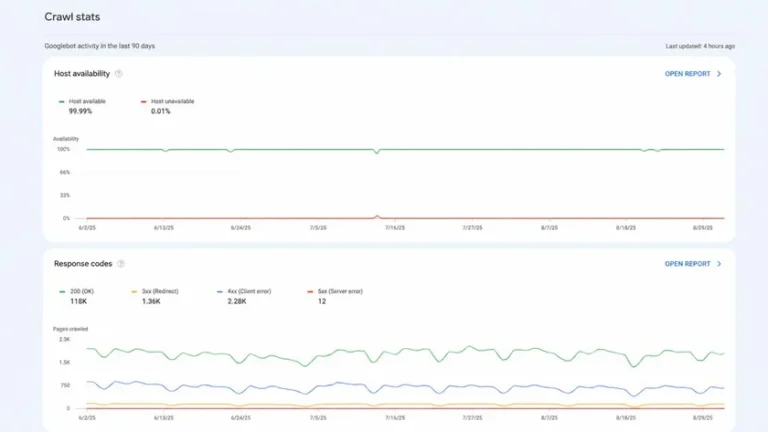
Dokumentasi Google Search Central menyarankan cek availability: jika server menunjukkan masalah ketersediaan, Googlebot dapat mengurangi crawling agar tidak overload situs.
Sinyal teknis kuat termasuk lonjakan 5xx, latency tinggi, Hostload exceeded di URL Inspection, atau grafik host availability di Crawl Stats. Namun jangan mendiagnosis tanpa log—intermittent error sering terlewat bila Anda hanya tes sekali di browser.
Site WordPress di shared hosting Indonesia kadang spike saat backup plugin atau cron berjalan bersamaan dengan crawl Google. Lalu bandingkan waktu error GSC dengan log server dan CDN bila ada.
Crawl demand dan perceived quality
Penyebab kedua menurut Mueller: crawl demand rendah. Jika sistem Google menilai tidak perlu crawl banyak lagi dari situs, Google bisa melewati sitemap meski valid dan reachable—bukan kegagalan HTTP klasik.
Mueller menyebut crawl demand «very often based on the perceived quality of a website». Itu memengaruhi seberapa banyak Google crawl, masuk index, dan apakah Google memakai sitemap pada saat itu. Tetapi status Couldn’t fetch di GSC bukan label resmi «kualitas rendah»; jangan reverse logic dari satu baris laporan.
Roger Montti di Search Engine Journal (Oktober 2026) membingkai bagian crawl-demand sebagai «quality issue». Wording Mueller sendiri lebih spesifik: crawl demand dan perceived quality—bukan skor E-E-A-T publik atau domain authority.
Bila teknis sudah bersih tetapi crawl/index stagnan, tinjau inventori konten: duplikasi, halaman tipis, index bloat. Panduan ciri artikel SEO berkualitas rendah membantu audit konten tanpa langsung menyalahkan file sitemap.
Sitemap hint, bukan jaminan crawl
Google Search Central konsisten: sitemap membantu discovery dan memberi hint URL penting; tidak menjamin Google crawl dan index setiap URL. Jadi Google tidak berkewajiban fetch setiap sitemap seketika setelah submit.
Mueller juga mengatakan Google kadang sudah punya cukup informasi dan tidak membutuhkan sitemap pada waktu itu. Bila demand naik later, Google dapat fetch lagi—tanpa SLA hari yang bisa Anda janjikan ke klien.
Halaman tetap bisa masuk index lewat internal link dan sinyal discovery lain. Status Couldn’t fetch sambil sebagian URL sudah indexed di Page Indexing report bukti issue tidak selalu «bencana deindex».
Selain itu, selisih jumlah URL sitemap vs GSC sering membingungkan merchant. Baca kenapa sitemap website tidak sama dengan GSC agar tidak mencampur error fetch dengan perbedaan hitungan normal.
Checklist troubleshooting sitemap Search Console
- Cek HTTP status sitemap (target 200; waspadai 3xx berantai, 4xx, 5xx intermiten).
- Validasi XML (well-formed, namespace benar, URL absolut, batas 50.000 URL / 50 MB per file).
- Cek robots.txt: tidak memblok sitemap; directive
Sitemap:mengarah ke URL canonical HTTPS. - Tes redirect hostname (www/non-www, HTTP→HTTPS) tanpa loop.
- Review WAF/CDN: bot fight, challenge, rate limit—verifikasi lewat log, bukan asumsi.
- Buka Crawl Stats: host availability, response codes, robots fetch.
- Cek access log: apakah Googlebot meminta sitemap? Kode respons? (verifikasi bot resmi bila ragu).
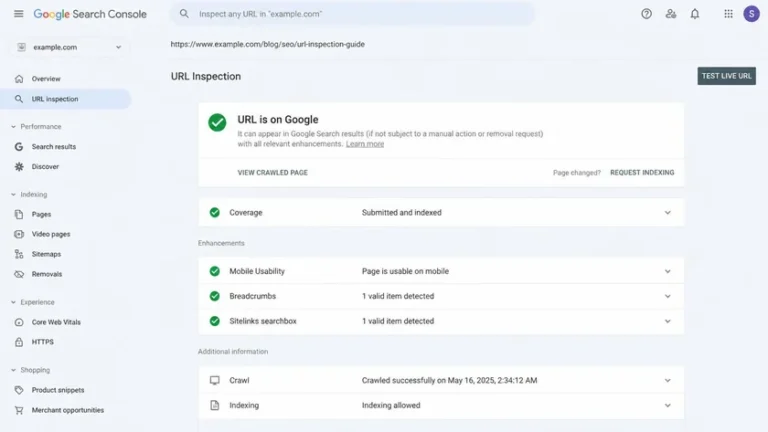
- URL Inspection pada URL contoh dari sitemap—not hanya homepage.
- Jika semua teknis sehat: evaluasi crawl demand, nilai konten, internal linking; hindari resubmit unchanged berkali-kali per hari.
Google menyarankan menghindari submit sitemap yang tidak berubah berulang-ulang; resubmit tidak memaksa crawl atau memperbaiki crawl demand.
Untuk WordPress, pastikan endpoint sitemap aktual (core, Yoast, atau plugin SEO)—jangan tebak URL. Konflik plugin atau cache layer bisa mengubah respons tanpa syntax error.
Bedakan error teknis dan prioritas Google
Crawl capacity (site mampu melayani crawl) dan crawl demand (Google ingin crawl) adalah dua sisi berbeda. Menambah kapasitas server tidak otomatis menaikkan demand; demand tinggi dengan server lemah justru memicu throttle.
Secara praktek kami sering bertemu masalah ini terutama sekali pada website baru. Mungkin itu cuma perasaan? tapi berdasarkan kejadian sebenarnya memang begitu adanya.
Dan bukan itu saja, web dengan konten yang baru sedikitpun sering terjadi seperti itu.
Couldn’t fetch bukan manual action, bukan penalty, bukan bukti Google «menghukum» dengan mengabaikan sitemap permanen. Manual Actions report tetap worth cek bila situs punya masalah compliance terpisah.
Menurut kami, ubah priority atau changefreq di XML hampir tidak relevan untuk memperbaiki Couldn’t fetch—Google tidak memakai field itu seperti era lama. Memalsukan lastmod massal juga bisa membuat Google mengabaikan timestamp.
Visibilitas organik lemah kerap campur aduk dengan masalah crawl. Berita posisi website tidak naik membahas sinyal ranking terpisah—jangan kaitkan satu status sitemap dengan ranking langsung.
Podcast sumber: Search Off the Record — Do sitemaps still matter? (bagian ~22:05). Ringkasan media: Search Engine Journal. Docs sitemap: overview dan build sitemap.
Setelah checklist, fokus perbaikan nyata: perbaiki 5xx/WAF, rapikan canonical di sitemap, perkuat halaman bernilai—not ritual submit. Tim CodeF saat maintenance WordPress sering cross-check endpoint sitemap, robots, dan Crawl Stats sebelum klien UMKM mengira «konten kami di-blacklist Google».