Pada 6 Oktober 2026 UTC, Google menata ulang bagian darurat pengurangan crawl rate Google. Google menambahkan contoh header HTTP Retry-After.
Dukungan Retry-After bukan mekanisme baru. Panduan menjeda situs sudah membahas header itu. Google memindahkan penjelasan supaya mudah ditemukan saat server kewalahan.
Barry Schwartz melaporkan perubahan dokumentasi lewat Search Engine Roundtable (SERoundtable). Changelog Crawling Infrastructure mencatat entri yang sama (changelog Google).
Google menempatkan teknik ini di bawah judul «Urgently reduce crawler traffic (for emergencies)»—bukan alat tuning SEO rutin. Durasi yang Google sarankan: beberapa jam hingga sekitar satu hingga dua hari.
Apa yang berubah di dokumentasi crawl rate?
Inti pembaruan: penjelasan Retry-After dan contoh sintaks masuk ke halaman «Reduce the Google crawl rate» (panduan resmi). Google memperbarui halaman itu pada 6 Oktober 2026.
Jadi infrastruktur crawling Google otomatis menyesuaikan kecepatan crawl. Tujuannya: banyak halaman terambil tanpa membebani server. Kondisi darurat memaksa respons error.
Sementara itu, Google menyebut respons 500, 503, atau 429 sebagai pengganti 200 pada permintaan crawl bila perlu menurunkan beban. URL bermasalah yang signifikan dapat memperlambat laju crawl seluruh hostname—not hanya URL yang mengembalikan error.
Namun Google menempatkan Retry-After dalam dokumentasi 503 dan 429—not sebagai rekomendasi otomatis untuk setiap 500. Header itu standar HTTP (RFC 9110), bukan header khusus Google.
Format Retry-After dan status code darurat
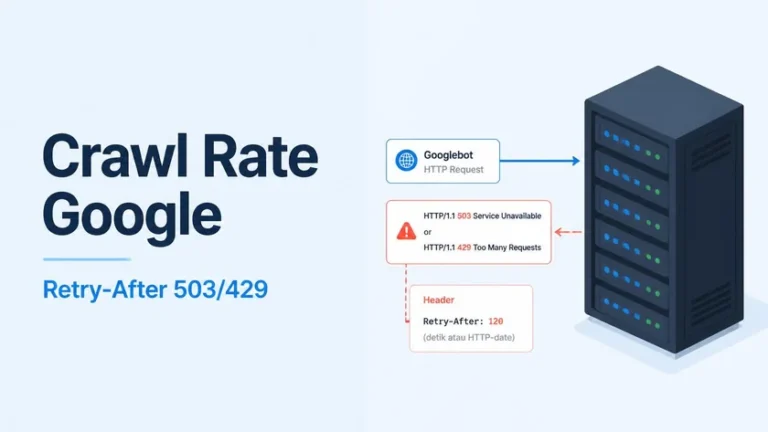
Bila Anda mengembalikan 503 Service Unavailable atau 429 Too Many Requests, Google docs memungkinkan menambahkan Retry-After. Contoh delay dalam detik:
HTTP/1.1 503 Service Unavailable
Retry-After: 120
Crawler mendapat petunjuk untuk mencoba lagi setelah jeda 120 detik. Meski begitu, itu bukan jaminan Googlebot kembali tepat pada detik itu. Alternatifnya, tanggal absolut UTC:
HTTP/1.1 503 Service Unavailable
Retry-After: Wed, 21 Oct 2026 07:28:00 GMT
Google memperingatkan: jangan memakai 401, 403, 404, atau 410 sebagai sinyal rate limiting. 429 adalah pengecualian 4xx yang Google perlakukan sebagai overload (status HTTP crawling). Mengganti 503 dengan 403 mengubah makna semantik.
Dampak crawl rate Google pada hostname dan indeks
Ketika error 500/503/429 menurun, crawl rate Google naik lagi secara bertahap. Google tidak memublikasikan SLA pemulihan jam per jam.
Jika respons error pada URL yang sama berlangsung beberapa hari, Google may drop URL from the index. Itu kemungkinan—not deadline tetap 48 jam.
Maka halaman baru lebih jarang ditemukan. Halaman lama jarang Google refresh ulang. Halaman yang sudah dihapus bisa lebih lama tersisa di indeks.
Publisher yang memantau visibilitas organik perlu memisahkan gejala ini dari fluktuasi posisi ranking website biasa.
Di ranah Ads, Google Ads bisa ikut terdampak. Google Ads bisa menjeda atau membatalkan kampanye bila crawler Ads tidak mendapat konten. Untuk situs pencarian organik saja, catatan singkat itu cukup.
Cek log dan penyebab lonjakan crawl
Sebelum membatasi crawler, Google menyarankan meninjau hosting dan access log. Tujuannya: melihat bot atau pola URL mana yang memicu beban.
Kemudian, Google sering menyinggung faceted navigation, kalender tanpa batas tanggal, atau target Dynamic Search Ads sebagai pemicu lonjakan—not masalah «Googlebot terlalu agresif» semata.
Lantaran itu, verifikasi identitas bot lewat reverse DNS dan rentang IP resmi Google—not hanya string User-Agent. Crawler palsu bisa mengecoh (verifikasi permintaan Google).
Tim operasional bisa melengkapi langkah itu dengan panduan menyaring traffic bot di GA4 dan Cloudflare bila traffic non-Google ikut membebani origin.
Ternyata Google membahas parent path dan crawl demand URL baru terpisah. Konteksnya relevan bila lonjakan crawl berasal dari struktur URL, bukan outage (berita parent path crawl demand).
robots.txt dan limiter Search Console lama
Walau demikian, robots.txt tidak mengontrol crawl rate secara granular. Memblokir seluruh situs via disallow bukan pengganti throttling darurat yang aman.
Jadi Google menghentikan crawl-rate limiter lama di Search Console. Sejak Januari 2024 pengaturan itu tidak lagi tersedia (blog deprecation limiter).
Bila sitemap valid tetapi fetch gagal di GSC, gejala server berbeda dari emergency 503. Bedakan diagnosa sebelum mengirim error massal (penjelasan sitemap Couldn’t Fetch).
Menurut kami, Retry-After plus 503/429 adalah rem darurat, bukan strategi mengoptimalkan crawl budget. Perbaiki kapasitas server dan arsitektur URL dulu.
Bila beban tetap kritis, tim pemilik situs kerap meminta CodeF mengecek log dan respons HTTP sebelum kampanye SEO organik di-scale. Kami tidak menjanjikan normalisasi crawl dalam waktu tertentu.