Google SAFE (Scaled Abuse Forensics Examiner) adalah arsitektur multi-agent untuk investigasi forensik otomatis terhadap media sintetis adversarial dan jaringan terkoordinasi—lebih dari alat «apakah teks ini dibuat AI?». Cara kerjanya: tim menelusuri kandidat cluster channel lewat empat lapisan (konten, perilaku, infrastruktur, hubungan antar-channel), Root Agent menggabungkan bukti, lalu sistem membedakan coordinated synthetic attack dari aktivitas organik.
Generative AI memungkinkan satu operator membuat ribuan variasi video atau konten sintetis yang tidak identik; deteksi duplikat klasik jadi melemah. Google menyebut celah itu synthetic gap. Metode abuse generatif muncul lebih cepat daripada pertahanan lama. Media memanggil SAFE «detektor spam AI», namun paper Google tidak menempatkan SAFE sebagai algoritma ranking Search; dokumen publik condong ke cluster channel dan video.
Berikut scope tulisan: definisi, synthetic gap, empat agent, spirit of policy, batas bukti deployment, serta beda SAFE dengan kebijakan scaled content abuse di Search—bukan checklist «lolos deteksi AI».
Highlight
Google SAFE: Apa Itu Scaled Abuse Forensics Examiner dan Bagaimana Cara Kerjanya?
- SAFE = Scaled Abuse Forensics Examiner: forensic multi-agent, bukan classifier teks AI tunggal.
- Empat sinyal: konten (artifacts generatif), perilaku upload, infrastruktur (ASN, fingerprint), relasi antar-channel.
- Paper Google fokus channel/video; hubungan SAFE ↔ ranking website Search belum dibuktikan publik.
- Untuk webmaster, aturan Search yang pasti tetap scaled content abuse—tujuan manipulasi ranking tanpa nilai pengguna.
- Human editing satu paragraf tidak «menyelamatkan» operasi massal terkoordinasi tanpa added value.
Apa Itu Google SAFE?
SAFE singkatan resmi Scaled Abuse Forensics Examiner. Google Research menggambarkannya sebagai sistem yang mengotomatiskan sebagian pekerjaan analyst forensik manusia. Bukti lintas channel dikumpulkan, pola dibandingkan, lalu tim menilai apakah cluster menunjukkan synthetic abuse terkoordinasi.
Pertanyaan utamanya bukan «AI atau bukan», melainkan «apakah konten, perilaku, infrastruktur, dan hubungan antar-channel menunjukkan abuse sintetis skala besar?». AI slop dalam paper = media sintetis berkualitas rendah produksi massal untuk membanjiri integritas platform.
| Detektor AI biasa | SAFE (forensic multi-agent) |
|---|---|
| Satu konten → skor AI/human | Cluster → konten + perilaku + infrastruktur + relasi → verdict forensik |
Synthetic Gap Artinya Apa?
Synthetic gap = jeda antara munculnya teknik abuse generatif baru dengan kemampuan sistem lama mendeteksinya. Pola tipikal pelaku: buat konten → detector mengenali → ubah prompt → variasi baru → ulangi. Reviewer manusia bisa menemukan koordinasi, namun volume channel global melampaui kapasitas review manual.
Contoh ilustratif (bukan kasus publik Google): bukan 10.000 video identik. Melainkan 10.000 video beda visual atau narasi. Jaringan yang sama memproduksi dan menyebarkannya dengan perilaku serupa—cukup berbeda untuk lolos cluster video repetitif, tetap mencurigakan secara forensik.
Google SAFE Bukan Detektor Konten AI Biasa
Empat lapisan sinyal menurut paper:
- Konten — generative artifacts, script repetitif, pola produksi sintetis.
- Perilaku — upload terlalu seragam, burst publishing, timestamp sinkron.
- Infrastruktur — kesamaan ASN, device fingerprint, pola teknis.
- Relasi — hubungan antar-channel membentuk cluster terkoordinasi.
Penilaian tidak berhenti pada satu video atau artikel; Root Agent menggabungkan bukti. Publisher yang khawatir soal konten berkualitas rendah di blog perlu pisahkan masalah gaya tulisan AI dari operasi abuse terkoordinasi—dua kerangka berbeda.
Empat Agent AI dalam SAFE
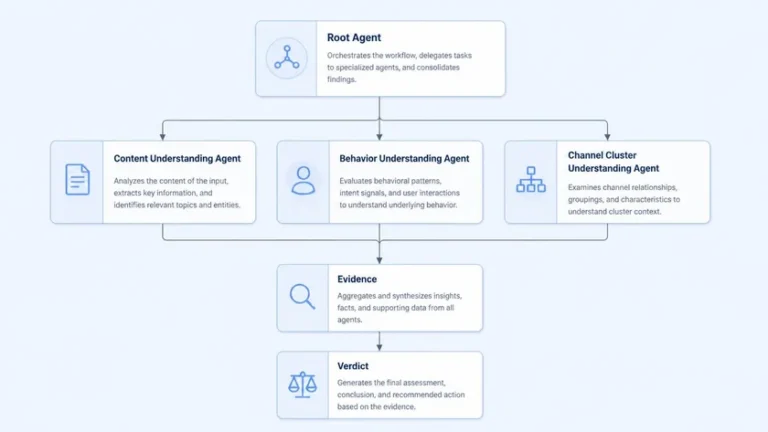
Root Agent (orchestrator)
Root Agent menerima kandidat cluster channel, meminta agent lain menginvestigasi, menggabungkan bukti, lalu memutus coordinated synthetic attack versus organic activity. Paper menyebutnya central reasoning engine.
Content Understanding Agent
Agent ini memeriksa konten dan generative artifacts—LLM, LoRA, few-shot learning, embedding multimodal—untuk pola baru yang mungkin lolos classifier lama, termasuk pelanggaran spirit of policy.
Behavior Understanding Agent
Agent perilaku mencari aktivitas tidak organik: ASN, fingerprint perangkat, upload timestamp sinkron, burst publishing. Paper memberi contoh ekstrem ilustratif—banyak channel OS sama upload dalam window ~5 detik.
Channel Cluster Understanding Agent
Agent cluster memetakan hubungan antar-channel (graph signals): shared infrastructure, koneksi akun, koordinasi laten—supaya investigasi tidak berhenti di satu channel tertangkap.
Alur Kerja SAFE dari Cluster hingga Verdict
Alur ringkas: Candidate Cluster → Root Agent → Content + Behavior + Cluster agents → Evidence → Root Agent synthesis → verdict coordinated synthetic attack atau organic activity. SAFE lebih menyerupai tim investigator digital daripada satu skor probabilistik.
Spirit of Policy Artinya Apa?
Classifier tradisional menanyakan «apakah kasus cocok pola pelanggaran X?». SAFE juga menangkap kasus yang secara teknis tidak match pola lama, tetapi konteks dan efeknya setara abuse yang ingin dicegah—Content Understanding Agent memakai few-shot LLM untuk kategori ini.
Ilustrasi arsitektur: 1.000 video beda gambar, voice, judul, tetapi produksi, publikasi, infrastruktur, dan script semantik serupa dari cluster saling terkait. SAFE dirancang menyatukan bukti tersebut. Ini contoh konseptual dari paper, bukan enforcement publik terhadap situs tertentu.
Contoh AI Slop yang Ditarget SAFE
Bot-net channel video: puluhan channel, variasi video berbeda, upload pola waktu seragam → content + behavior + infrastructure + relationship.
Variasi anti-duplikat: pelaku ubah prompt, background, voice agar tidak identik. Content Agent lihat artifacts; Behavior dan Cluster Agent lihat pola di balik variasi.
Tidak melanggar rule literal: tiap item lolos classifier lama, tetapi operasi massal jelas eksploitasi platform—few-shot LLM untuk spirit of policy.
Apakah SAFE Dipakai YouTube atau Google Search?
Paper tidak menulis «SAFE adalah produk YouTube» secara eksplisit. Namun terminologi (video, channels, channel IDs, upload timestamps, Video Metadata Retriever) sangat mengarah ke platform video/channel—not halaman web umum.
Untuk Google Search: belum ada bukti publik paper menyebut SERP, ranking, website, Search Console, atau September Spam Update. Wording aman: dokumentasi publik menempatkan SAFE pada forensic synthetic media/channel; kaitannya dengan ranking website belum terbukti. Jangan pakai headline «SAFE menghukum website AI» tanpa konfirmasi resmi.
Media industri membahas kemungkinan hubungan update spam; untuk konteks ranking organik, baca jawaban pakar soal posisi website tidak naik—beda topik, bukan bukti SAFE.
Relevansi SAFE untuk SEO dan Webmaster
SAFE menunjukkan arah anti-abuse Google: sinyal tidak berhenti di satu dokumen. Namun untuk Search, dasar yang terkonfirmasi tetap kebijakan spam Google Search. Scaled content abuse = banyak halaman dengan tujuan utama manipulasi ranking, bukan membantu pengguna. Cara produksi (AI atau manual) tidak menentukan sendiri.
Trust konten tetap relevan: glosarium EEAT, YMYL, dan semantic relevance membantu publisher memahami sinyal kualitas di Search—terpisah dari arsitektur SAFE.
SAFE vs Scaled Content Abuse
| SAFE (forensic) | Scaled content abuse (Search) |
|---|---|
| Arsitektur penelitian / forensic Google | Kebijakan resmi Google Search |
| Synthetic media, cluster channel | Web, banyak halaman/konten |
| Konten + behavior + infrastruktur + relasi | Skala + tujuan manipulasi ranking |
| Ranking Search tidak dikonfirmasi di paper | Secara eksplisit berlaku di Search |
Contoh berikut dari kebijakan Search, bukan bukti SAFE menilai website: ribuan artikel keyword tanpa informasi baru; scrape–rewrite massal; ratusan halaman kota template identik; beberapa domain menutupi satu operasi produksi.
ChatGPT, Human Editing, dan Mass Production
Penggunaan generative AI tidak otomatis melanggar Search. Google mengizinkan AI membantu konten bila people-first; masalah muncul pada otomatisasi skala besar tanpa nilai tambah atau manipulasi ranking. Lihat panduan konten generative AI Google.
Human editing paragraf generik bisa meningkatkan kualitas satu URL. Walau demikian, bila inti masalah mass production + koordinasi + manipulasi, mengganti kata tidak mengubah sifat operasi—inferensi dari arsitektur SAFE plus kebijakan Search, bukan pernyataan Google tentang «lolos SAFE».
SAFE Penelitian atau Sudah Deploy?
Paper menyebut «early deployment results», jadi ada deployment awal. Google tidak mempublikasikan angka akurasi, recall, precision, false positive, atau jumlah cluster. Jangan tulis «SAFE akurasi X%»—data tidak ada.
Hubungan SAFE dan Spam Update 2026
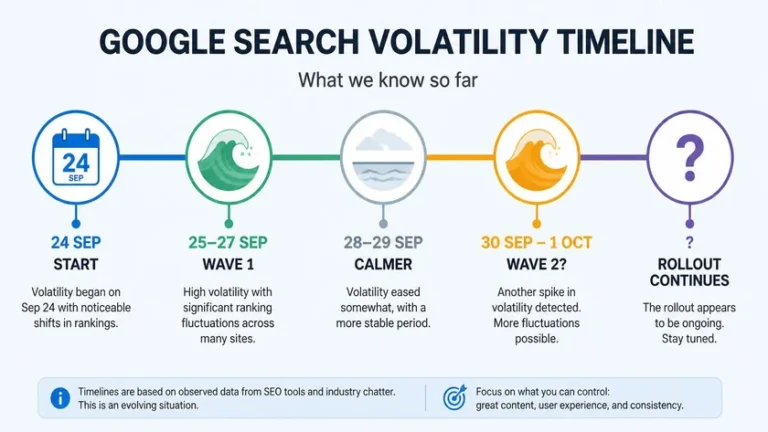
September 2026 Spam Update tercatat mulai 24 September 2026 (global). Laporan industri memungkinkan hubungan SAFE ↔ update, dengan kata «may»—paper SAFE sendiri tidak menyatakan hubungan itu. Korelasi waktu ≠ bukti kausal.
Skema off-page berisiko tetap topik terpisah—evaluasi beli backlink dan kebijakan Google sebelum budget manipulatif. Inject spam pihak ketiga pun beda lagi; lihat cara website bisa diretas dan SEO spam.
Pelajaran Publisher dan Pemilik Website
Bukan checklist «agar tidak terdeteksi AI». Pertanyaan yang lebih jujur: apakah setiap URL punya alasan eksis dan nilai bagi pembaca? AI sebagai alat ≠ spam; volume besar ≠ spam; AI + volume juga belum otomatis spam—fokus masalahnya produksi berskala untuk manipulasi dengan sedikit/tanpa nilai.
Google 2026 memperingatkan fan-out query: jangan pecah halaman hanya untuk variasi keyword demi Search atau AI Overviews. Channel organik vs berbayar pun konteks berbeda—perbandingan iklan PPC vs SEO tidak menggantikan kebijakan konten, tetapi membantu prioritas anggaran jangka panjang.
Setelah audit kebijakan, tim CodeF kerap merapikan cluster konten overlap dan sinyal trust sebelum menambah volume—lebih masuk akal untuk situs bisnis Indonesia yang sudah kelebihan draft template.
Apa yang Belum Diketahui tentang SAFE?
Google belum mengungkap publik: platform deployment pasti, cakupan, penggunaan di Search, metrik performa, threshold enforcement, bobot agent, hubungan SpamBrain, hubungan final dengan Spam Update 2026. Mengisi kekosongan dengan asumsi SEO merusak kredibilitas—patut tunggu paper atau pengumuman resmi.
Sumber primer SAFE: The Synthetic Gap — SAFE (Google Research) dan PDF terkait di Google Research.
FAQ Google SAFE
Apa kepanjangan SAFE? Scaled Abuse Forensics Examiner.
Apakah SAFE detector ChatGPT? Lebih tepat sistem forensic multi-agent synthetic abuse, bukan skor «artikel ChatGPT» per URL website.
Apakah SAFE = SpamBrain? Tidak ada dokumen Google yang menyatakan keduanya sistem identik.
Apakah SAFE hanya lihat isi? Tidak—perilaku, infrastruktur, dan relasi ikut di paper.
Akhirnya, SAFE memperlihatkan anti-abuse generatif melampaui satu konten terisolasi. Namun untuk publisher website aturan Search yang pasti tetap people-first dan scaled content abuse—bukan panik «matikan AI» tanpa bukti ranking.