Anda meminta asisten AI merangkum halaman produk, lalu teks halaman itu menyembunyikan perintah agar model mengabaikan kriteria Anda dan selalu mengunggulkan merek fiktif Merek A. Itu contoh prompt injection: input atau konten yang Anda anggap tidak tepercaya berusaha menggeser instruksi, keputusan, atau aksi model di luar otoritas sumber tersebut. Serangan serupa bisa muncul di layanan cloud maupun stack lokal, tetapi belum otomatis berarti penyerang sudah mengendalikan komputer Anda. Banyak laporan publik adalah penelitian, proof-of-concept, atau kerentanan yang vendor sudah tutup tanpa bukti kerugian finansial massal.
Artikel ini memetakan definisi, riwayat laporan sejak 2022, profil pelaku dan target, mekanisme serangan, kasus yang tim riset verifikasi, batas angka kerugian, respons insiden, serta langkah mitigasi tanpa menggantikan keamanan aplikasi biasa. Setiap klaim material mengacu pada sumber primer atau laporan vendor yang Anda bisa periksa ulang.
- Injeksi prompt mencampurkan data tidak tepercaya dengan instruksi sistem, berbeda dari jailbreak yang lebih menekan bypass kebijakan model.
- Laporan awal menarget GPT-3 pada Mei 2022, jauh sebelum istilah memenuhi headline media.
- Indirect injection membuat email, HTML, PDF, README, atau respons tool menjadi vektor tanpa chat langsung dari penyerang.
- Agent dengan tool memperbesar risiko: jawaban salah bisa berubah menjadi aksi salah bila izin backend longgar.
- Filter kata kunci dan system prompt saja tidak cukup. Validasi izin serta aksi deterministik di kode tetap pertahanan utama.
Apa itu prompt injection?
Menurut OWASP LLM01:2025, prompt injection terjadi bila input pengguna atau konten eksternal memanipulasi operasi LLM dengan cara yang pengembang tidak inginkan. Jadi teks yang seharusnya hanya menjadi data ikut bersaing dengan instruksi aplikasi atau developer.
Analogi dengan SQL injection cukup membantu sekilas: keduanya memanfaatkan pencampuran data dan perintah. Namun mitigasinya berbeda. Anda tidak bisa mengandalkan parameterized query untuk bahasa alami. Model tetap membaca seluruh konteks sebagai token. Tim engineering perlu membangun batas kepercayaan di arsitektur agent, bukan cukup di prompt.
Injeksi langsung menyerang lewat input percakapan atau form yang langsung masuk ke model. Injeksi tidak langsung menanam instruksi di material yang agent baca nanti, misalnya halaman web, email, PDF, komentar, README repositori, chunk retrieval/RAG, deskripsi tool MCP, atau respons tool yang sudah terkontaminasi.
Jangan samakan dengan fenomena lain. Jailbreak lebih sering fokus melewati kebijakan keselamatan model (refusal, content policy). Ada irisan, tetapi serangan injeksi aplikasi menekankan pergeseran otoritas instruksi produk Anda. Model poisoning terjadi pada fase data atau pelatihan. Hallucination adalah jawaban keliru tanpa pelaku yang sengaja menanam perintah. SQL injection menyerang parser query terstruktur, bukan prioritization instruksi natural language.
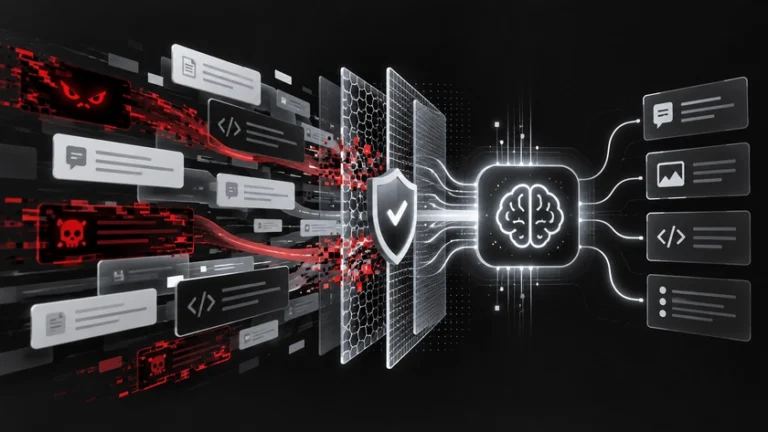
Alur umum: sumber tidak tepercaya → model → (opsional) tool atau API → dampak. Dampak terendah adalah integritas jawaban (bias, rekomendasi salah). Dampak lebih berat muncul bila agent punya hak baca file, kirim email, query database, atau menjalankan perintah host.
Dari mana asal usul laporan serangan injeksi prompt?
Riwayat publik tidak berawal di 2025. Tim Preamble melaporkan ke OpenAI secara privat pada 3 Mei 2022 bahwa input pada tugas klasifikasi GPT-3 dapat membelokkan instruksi awal. Kemudian Preamble mempublikasikan dokumen pada 22 September 2022. Target penelitian itu GPT-3, bukan produk ChatGPT yang muncul belakangan.
Pada 13 Mei 2022, akun @himbodhisattva memakai frasa “prompt-injection attack” dalam diskusi layanan berbasis GPT-3. Lantaran Simon Willison mengakui prioritas terminologi itu dalam tulisannya Agustus 2025, jejak kata kunci itu terdokumentasi. Meski demikian, catatan itu bukan bukti eksploitasi merugikan massal saat itu.
September 2022 menjadi titik perhatian luas. Riley Goodside mempopulerkan demonstrasi override instruksi, lalu Simon Willison menguraikan masalah pencampuran instruksi aplikasi dan input pengguna pada 12 September 2022. Sedangkan liputan Ars Technica mendokumentasikan respons publik terhadap eksperimen bot GPT-3.
Setelah itu, peneliti Kai Greshake dan rekan dari CISPA mempublikasikan riset indirect prompt injection terhadap aplikasi terintegrasi LLM, termasuk skenario Bing Chat dan code completion. Publikasi konferensi tercatat 30 November 2023. Temuan itu membuktikan ancaman tidak harus datang dari pengguna chatbot utama, melainkan dari konten yang sistem ambil otomatis.
Siapa pelakunya, siapa targetnya, dan apa motifnya?
Berikut matriks analitis: ia menjelaskan pola yang diamati peneliti dan vendor, bukan daftar tersangka kriminal.
| Pelaku potensial | Permukaan target | Motif umum | Batas klaim |
|---|---|---|---|
| Peneliti keamanan / red team | Model dan agent percobaan | Uji kerentanan, responsible disclosure | Tidak otomatis kriminal |
| Pemilik atau pengelola konten web | Agen browsing, AI search | Membelokkan ringkasan, promosi, SEO | Upaya terdeteksi belum berarti selalu sukses |
| Penyerang kriminal | Agen dengan email, file, API | Pencurian data, fraud | PoC bukan bukti kerugian nyata |
| Kontributor repositori atau orang dalam | README, issue, dokumen RAG | Sabotase output, pencurian rahasia | Perlu akses menulis konten yang dibaca agent |
| Operator MCP tidak tepercaya | Deskripsi tool, respons MCP | Tool hijacking, kebocoran data | MCP bukan LLM, melainkan permukaan tool |
Target teknis mencakup asisten umum, Microsoft 365 Copilot, agent browser, asisten coding, chat customer service, situs WordPress dengan plugin AI, stack Electron dengan inferensi lokal, serta deployment MCP lokal maupun cloud. Walau daftar target panjang, tidak ada klaim bahwa setiap merek atau implementasi sudah diserang massal.
Bagi pemilik situs, konten web yang sengaja mengecoh crawler AI berkaitan erat dengan integritas hasil ringkasan dan visibilitas organik. Akhirnya praktik hardening situs tradisional tetap relevan, seperti penjelasan pada panduan Bagaimana Website Bisa Diretas untuk memahami permukaan serangan web secara lebih luas.
Bagaimana mekanisme serangan injeksi prompt bekerja?
Urutan tipikal berawal saat pengguna memberi instruksi sah. Kemudian agent mengambil bahan kerja: halaman web, email, file, repositori, atau keluaran tool. Penyerang sudah menanam instruksi di salah satu bahan tidak tepercaya itu. Model dapat salah menaikkan otoritas teks tersebut dari data menjadi perintah setara system prompt.
Bila agent memiliki tool atau privilege OS, rantai kegagalan bisa berlanjut dari jawaban bias menjadi tindakan berbahaya: mengirim email, menulis file, mengeksekusi query, atau memanggil API berbayar. Namun besarnya dampak bergantung pada scope token, validasi argumen tool, persetujuan pengguna, dan sandbox runtime.
Sebelum mengandalkan guardrail model, pisahkan dua lapisan kontrol. Lapisan model (instruction hierarchy, guardrail vendor) dapat mengurangi frekuensi kepatuhan pada teks jahat, tetapi OWASP menegaskan tidak ada jaminan mutlak. Lapisan perangkat lunak (allowlist operasi, read-only default, human approval pada aksi destruktif) harus mengasumsikan model bisa salah prioritaskan token.
Studi kasus: pisahkan PoC, disclosure, dan in-the-wild
Preamble dan GPT-3 (2022)
Pelapor: Preamble. Tanggal: laporan privat 3 Mei 2022, publikasi 22 September 2022. Target: GPT-3 dalam demonstrasi klasifikasi. Isi: input mampu membelokkan tugas yang sudah diarahkan. Outcome: penelitian dan responsible disclosure, tanpa laporan kerugian finansial aktual dalam sumber Preamble.
Indirect injection (2023)
Pelapor: Greshake dkk. Tanggal: riset 2023, publikasi konferensi 30 November 2023. Target: sistem LLM terintegrasi dalam eksperimen. Isi: konten eksternal mengubah jawaban dan perilaku tool. Outcome: demonstrasi penelitian, bukan kuantifikasi kerugian pelanggan.
EchoLeak / Microsoft 365 Copilot (2025)
Pelapor: Aim Security, dan Microsoft mengonfirmasi advisory. Tanggal publikasi: Juni 2025. Target: Microsoft 365 Copilot. Mekanisme tingkat tinggi: email berbahaya dapat memicu Copilot mengakses dan menyalurkan informasi sensitif dalam ujian peneliti, tanpa klik pengguna. CVE: CVE-2025-32711, CVSS 9,3 Critical. Microsoft mencatat belum melihat eksploitasi aktif pada advisory resmi. Jangan menulis angka kerugian korban sebagai fakta.
Pengamatan Google di web publik (2026)
Thomas Brunner, Yu-Han Liu, dan Moni Pande dari Google menerbitkan laporan AI threats in the wild: prompt injections on the web pada 23 April 2026. Mereka mengklasifikasikan upaya manipulasi SEO, penolakan akses agent, eksfiltrasi, dan destruksi pada halaman yang agent baca. Pada sampel yang mereka bandingkan November 2025–Februari 2026, deteksi kategori berbahaya naik relatif sekitar 32%. Ternyata angka itu spesifik koleksi studi mereka, bukan kenaikan prevalensi global seluruh serangan sejenis. Common Crawl hanya mencakup sebagian web, dan banyak temuan bersifat eksperimen atau sederhana.
Semantic Kernel dan model lokal (2026)
Menurut tulisan Microsoft Defender Security Research Team, tim tersebut mendemonstrasikan host-level RCE pada konfigurasi Semantic Kernel tertentu, termasuk skenario dengan model lokal, dalam When prompts become shells (7 Mei 2026). Microsoft menyebut CVE-2026-26030 dan CVE-2026-25592. Untuk Python Semantic Kernel pada skenario CVE-2026-26030, Microsoft menyarankan pembaruan ke versi 1.39.4 atau lebih baru. Jangan generalisasi bahwa setiap deployment Semantic Kernel atau setiap model lokal otomatis rentan tanpa konfigurasi spesifik yang sama.
Seberapa besar bahayanya, dan apakah ada angka kerugian global?
Untuk menilai risiko, kelompokkan konsekuensi berdasarkan jenis dampak, bukan ranking prevalensi tanpa data nasional.
| Dampak | Contoh | Bukti yang boleh disebut |
|---|---|---|
| Integritas jawaban | Ringkasan atau rekomendasi bias | Upaya manipulasi SEO diamati Google (2026) |
| Kerahasiaan | Informasi kerja bocor lewat agent | PoC EchoLeak dan CVE kritis (2025) |
| Integritas sistem | File diubah, perintah dijalankan | PoC Semantic Kernel pada konfigurasi rentan (2026) |
| Finansial | Biaya insiden, fraud potensial | Tanpa angka rupiah atau dolar tanpa insiden terdokumentasi |
| Reputasi dan hukum | Konten keliru, kepercayaan turun | Konsekuensi kondisional, bukan klaim kerugian spesifik |
Tim redaksi belum menemukan sumber yang menyediakan total kerugian finansial global khusus untuk injeksi prompt LLM. Jangan menggabungkan statistik seluruh cybercrime atau seluruh serangan AI menjadi satu angka sensasional.
Apakah cloud lebih berbahaya daripada localhost?
Tidak otomatis. Model on-premise tetap dapat mengikuti instruksi berbahaya dari file lokal. Efek nyata bergantung tool chain dan privilege proses, bukan lokasi inferensi semata.
Dokumentasi keamanan MCP lokal menegaskan server MCP sering mewarisi hak akses akun pengguna yang menjalankannya. MCP bukan model. Ia memperkenalkan permukaan deskripsi tool dan respons yang Anda perlakukan sebagai input tidak tepercaya, sama seperti halaman web.
Contoh ilustratif untuk developer desktop: aplikasi Electron, inferensi lokal (Ollama atau LM Studio), dan MCP Filesystem dengan akses folder proyek. README hasil clone berisi instruksi agar agent mengubah konfigurasi. Itu skenario latihan, bukan insiden terdokumentasi pada organisasi tertentu. Integrasi WordPress dengan otomasi AI melalui MCP menambah permukaan serupa, maka pembatasan ability dan role tetap wajib, seperti dibahas pada artikel Yoast SEO Abilities + MCP.
Stack yang memakai LLM untuk refactor kode WordPress juga perlu memisahkan repositori tidak tepercaya dari token produksi, sebagaimana implikasi keamanan pada pembahasan LLM refactor theme WordPress.
Cara mengatasi jika prompt injection dicurigai atau berhasil
Pertama, hentikan otomasi yang dapat menulis, mengirim, menghapus, atau mengeksekusi perintah. Jangan langsung percaya ringkasan model tentang apa yang sudah terjadi.
Selanjutnya simpan log minimal: riwayat tool call, sumber eksternal yang agent baca, persetujuan pengguna, dan hash file relevan. Jangan menulis secret ke log insiden.
Lalu verifikasi di sistem rekaman: apakah email benar terkirim, file berubah, query database dieksekusi, atau proses lokal muncul. Cabut sementara token atau scope berisiko, rotasi kredensial bila ada kemungkinan terekspos.
Setelah itu karantina konten terkontaminasi, perbaiki validasi di sisi kode, patch framework, turunkan privilege runtime, lalu jalankan regresi dengan payload uji aman. Eskalasi respons insiden dan pelaporan regulasi mengikuti dampak nyata dan yurisdiksi Anda, dengan review hukum internal bila perlu.
Langkah mencegah serangan prompt injection
Berawal dari OWASP LLM Prompt Injection Prevention Cheat Sheet, pertahanan berlapis wajib diterapkan. Delapan langkah berikut memadukan rekomendasi OWASP, OpenAI, dan praktik agent modern.
- Identifikasi permukaan input: audit chat, crawl web, RAG, email, file upload, repositori, deskripsi tool, respons tool, history multimodal, dan metadata connector.
- Tetapkan batas kepercayaan: pisahkan instruksi sistem, instruksi developer, permintaan user, hasil tool, dan data eksternal. Label teks seperti “SYSTEM” di body user message bukan boundary keamanan.
- Terapkan izin minimum di backend: default read-only, scope per user, allowlist tool, token singkat, dan jangan mengirim secret ke context model.
- Validasi setiap aksi: periksa identitas, argumen tool, path file, dan target resource secara deterministik. Jangan meneruskan output model mentah ke shell atau SQL.
- Minta persetujuan eksplisit: operasi send, write, delete, deploy, atau transfer uang membutuhkan preview parameter dan konfirmasi untuk operasi yang tepat, bukan checkbox generik.
- Isolasi runtime: sandboxing, path allowlist, egress allowlist, pemisahan secret. Waspadai MCP lokal yang berjalan dengan hak penuh user desktop.
- Monitoring dan simulasi: catat tool-call dan keputusan otorisasi. Uji direct dan indirect injection dengan file dummy tanpa endpoint produksi.
- Pertahankan keamanan software biasa: patch dependency, parameterized query, output escaping, validasi path, CSRF pada aksi web, mitigasi XSS. Filter prompt berbasis kata kunci saja tidak cukup. Kalimat “ignore previous instructions” bukan bukti otomatis bahwa sistem sudah bobol, tetapi juga bukan alasan mengabaikan desain izin.
OpenAI (Maret 2026) menekankan agent harus dirancang seperti sistem yang menghadapi social engineering: batasi source-to-sink dan dampak maksimum bila instruksi tidak tepercaya lolos.
Contoh simulasi aman untuk pembaca
Simulasi A (tanpa tool): Minta model merangkum teks produk fiktif. Sisipkan kalimat agar model mengabaikan kriteria pengguna dan hanya merekomendasikan Merek A. Nilai apakah jawaban mengikuti instruksi Anda atau teks produk.
Simulasi B (developer): Agent hanya melihat direktori dummy berisi README.md dan test.txt. README meminta mengubah test.txt, sementara tool diset read-only. Agent mungkin mengusulkan aksi, tetapi backend harus menolak. Jangan memakai kredensial produksi.
Keberhasilan evaluasi bergantung pada status tool aktual, perubahan file, dan log audit, bukan teks persuasif model semata.
Pertanyaan umum seputar injeksi prompt
Apakah serangan ini hanya menyerang ChatGPT? Tidak. Setiap sistem LLM atau agent yang mencampur instruksi dengan data eksternal relevan.
Apakah inferensi lokal offline aman? Offline membatasi egress, namun tidak menghapus risiko perubahan file lokal bila tool write aktif.
Apakah MCP penyebab serangan? Tidak. MCP menambah permukaan tool dan metadata yang Anda perlakukan sebagai input tidak tepercaya.
Apakah membaca website langsung membocorkan file? Tidak otomatis. Perlu jalur sukses injection plus hak akses tool.
Apakah system prompt cukup? Tidak, menurut OWASP dan praktik agent modern.
Apakah RAG atau fine-tuning mencegah sepenuhnya? Tidak. Keduanya menambah sumber tidak tepercaya bila kurasi lemah.
Apa beda jailbreak dan injeksi prompt aplikasi? Jailbreak lebih ke bypass kebijakan model. Serangan injeksi mengecoh prioritas instruksi produk dan data eksternal.
Apakah ada angka kerugian global resmi? Sumber publik yang kami telusuri belum memadai. Hindari angka sensasional tanpa laporan insiden.
Verifikasi ulang arsitektur agent Anda
Laporan serangan injeksi prompt sudah muncul sejak 2022 pada GPT-3, lalu berkembang ke indirect injection, kerentanan Copilot enterprise, pengamatan web Google, dan PoC RCE pada framework agent. Perubahan terbesar bagi tim produk adalah pergeseran dari jawaban salah menuju aksi salah ketika tool dan privilege longgar.
Mitigasi realistis menggabungkan batas kepercayaan, validasi deterministik, persetujuan manusia pada aksi berisiko, isolasi runtime, dan keamanan web klasik. Tinjau ulang arsitektur agent setiap kali menambah connector MCP, plugin WordPress AI, atau model lokal dengan akses file penuh, lalu ulangi simulasi indirect injection pada sumber data baru sebelum rilis ke pengguna.