Cloudflare Googlebot bisa kehilangan akses Search bila Anda memilih mode Block pada mixed-use crawler. Rule firewall yang menahan verified bot juga berisiko sama. Namun rilis final 15 September 2026 tidak memblokir Google Search secara blanket pada konfigurasi rekomendasi Cloudflare.
Untuk menolak AI training sambil tetap crawlable di Google, pisahkan Disallow AI Training dari Block. Post Glenn Gabe (6 Oktober 2026) mengangkat cuplikan Matthew Prince di The Verge soal risiko ranking.
Tim The Verge merekam wawancara itu sebelum 15 September; Prince memakai future tense soal default baru. Dokumentasi Cloudflare setelah tanggal itu jadi acuan teknis, bukan headline drama «Cloudflare vs Google».
Highlight
Cloudflare Bisa Blokir Googlebot? Bedakan AI Training dan Search agar Ranking Tidak Terganggu
- Interview Decoder (terbit 26 Sep 2026) merekam rencana sebelum implementasi 15 Sep—not current policy.
- Rekomendasi domain baru: Search tetap Allow; situs beriklan bisa Disallow AI Training + Agent dibatasi di halaman iklan.
- Disallow AI Training = sinyal no-training; Block = hard stop termasuk crawling Search untuk Googlebot/Bingbot/Applebot.
- Blokir Googlebot jangka panjang mengganggu refresh index; tidak ada jadwal ranking-drop universal.
- Audit: AI bot policies, WAF custom, robots.txt, Security Events, plus Crawl Stats di Search Console.
Apakah Cloudflare memblokir Googlebot secara default?
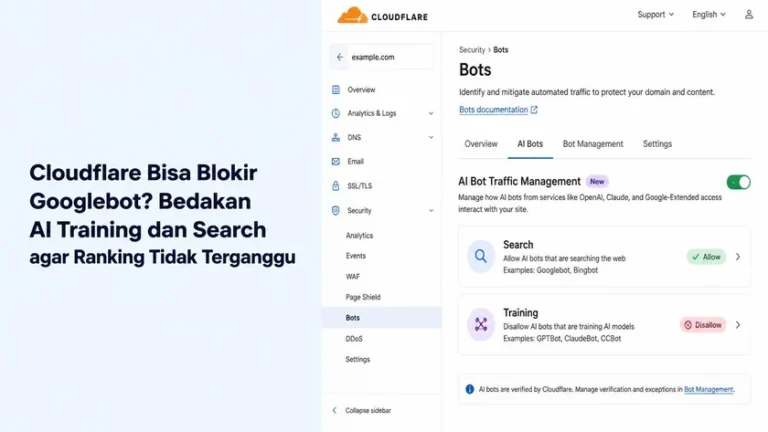
Maka jawaban singkat: tidak untuk Google Search pada skema recommended setelah 15 September 2026. Cloudflare memperkenalkan kontrol granular—Search, Training, Agent.
Publisher bisa menolak training tanpa memutus discovery di mesin pencari. Namun banyak orang salah membaca kutipan Prince soal «memblokir Google»—frasa itu mengacu rencana pra-rilis.
Selanjutnya, blog resmi Cloudflare (15 September 2026) merangkum Disallow AI Training dan desain Accountable untuk crawler multi-fungsi seperti Googlebot. Judul publikasi: Have it both ways: stay discoverable in search while disallowing AI training.
Bila headline media menyiratkan «Cloudflare memblokir Google sejak 15 September», koreksinya ada di baris Search = Allow pada rekomendasi domain baru. Meski begitu, risiko SEO nyata muncul saat owner sengaja memilih Block. WAF lain yang menahan bot crawl pun berbahaya.
Kronologi: Prince, Glenn Gabe, dan rilis 15 September
Berikut urutan waktu penting supaya Anda tidak menafsirkan quote interview sebagai kebijakan hari ini.
- Sebelum 15 Sep 2026 — Prince di podcast Decoder (The Verge) menjelaskan rencana default lebih keras, termasuk siap memblokir crawler bila Search dan Training tidak bisa dipisah.
- 15 Sep 2026 — Cloudflare merilis implementasi final dengan pemisahan Search / Training / Agent.
- 26 Sep 2026 — The Verge menerbitkan episode Decoder; transcript memuat kalimat «As of September 15th, we’re going to set the defaults…» dalam future tense saat perekaman.
- 6 Okt 2026 — Glenn Gabe mengangkat cuplikan wawancara sebagai hook SEO; bagian «cek setting» tetap relevan, konteks implementasi perlu diperbarui dengan docs Cloudflare.
Tetapi post X bukan sumber kebijakan Cloudflare. Gunakan sebagai pemicu berita. Klaim teknis harus cocok dengan dokumentasi AI bot terbaru.
Prince di wawancara The Verge juga membahas skala jaringan. Menurut Cloudflare, lebih dari 20% web berada di belakang network mereka. Angka itu milik Cloudflare, bukan ukuran presisi «seluruh internet».
Disallow AI Training vs Block pada Cloudflare Googlebot
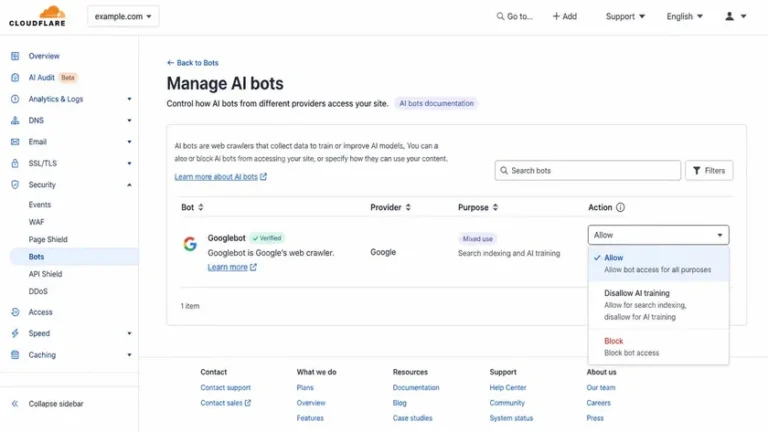
Tim marketing dan SEO Indonesia yang host di Cloudflare free maupun berbayar perlu beda ketiga mode ini.
Disallow AI Training — Cloudflare menyatakan crawler tetap mengakses situs untuk Search. Preferensi no-training lewat mekanisme yang Cloudflare sepakati dengan Google, Apple, dan Microsoft. Akhirnya, mode ini bukan firewall block penuh.
Block — edge Cloudflare menahan request mixed-use crawler. Dokumentasi menegaskan: Block pada Googlebot, Bingbot, atau Applebot menghentikan akses Search, bukan hanya training.
Jadi jangan memilih Block hanya karena ingin menolak AI training. Topik terkait sudah kami uraikan di tutorial Haruskah Block Bot AI. Mixed-use Googlebot butuh kontrol khusus, bukan rule generik «block all AI».
| Opsi Cloudflare | Akses Search (Googlebot) | AI training | Catatan SEO |
|---|---|---|---|
| Allow | Tersedia | Sesuai perilaku crawler | Risiko rendah dari opsi ini saja |
| Disallow AI Training | Rancangan CF: tetap tersedia | Training ditolak via sinyal | Bukan trik ranking; hak konten |
| Block | Dapat terhenti | Stop total | Dampak crawling/indexing nyata |
| Block on pages with ads | Terbatas per halaman | Tergantung klasifikasi | Halaman iklan mungkin tidak tercrawl |
Semantik UI bisa berubah; selalu cocokkan dengan label dashboard dan changelog docs sebelum publish SOP internal.
Search, Training, Agent: rekomendasi domain baru
Cloudflare mengelompokkan traffic AI menjadi tiga bucket. Search = indexing/discovery. Training = pengambilan konten untuk model. Agent = permintaan otomatis real-time atas nama pengguna.
Taxonomy ini milik Cloudflare, bukan standar universal industri. Untuk domain baru, blog 15 September merangkum rekomendasi berikut.
Situs tanpa monetisasi iklan: Search Allow, Training Allow, Agent Allow. Situs dengan iklan: Search Allow, Training Disallow AI Training, Agent Block on pages with ads.
Alasan Cloudflare: traffic training/agent tidak melihat iklan; publisher beriklan ingin melindungi inventory. Keputusan bisnis tetap berbeda per brand.
UMKM company profile di Jakarta mungkin prioritaskan discovery maksimal. Publisher berita mungkin ingin kontrol training. Tidak ada preset «Allow semua» atau «Block semua» untuk setiap niche.
Sementara itu, memfilter bot di laporan analytics terpisah dari kebijakan crawl Search. Panduan menyaring traffic bot di GA4 dengan GTM dan Cloudflare membantu agar spike bot tidak terbaca sebagai kampanye organik.
PageRank, argumen Prince—bukan pernyataan Google
Di transcript Decoder, Prince memakai PageRank/link graph sebagai ilustrasi. Apabila bagian besar web di belakang Cloudflare «hilang» dari crawler Google, graph hubungan antarhalaman kehilangan data.
Itu argumen CEO Cloudflare, bukan konfirmasi Google soal kerusakan ranking terukur. Ranking Google modern memakai banyak sinyal. PageRank historis masih relevan sebagai konsep authority link, namun bukan satu-satunya mekanisme.
Jangan menyimpulkan «PageRank rusak 20%» dari angka «20%+ web di Cloudflare». Cloudflare melaporkan proporsi itu; bukan eksperimen Google.
Blokir Googlebot jangka panjang mengganggu discovery halaman baru, refresh konten, dan update index. Visibility Search bisa menurun. Google Search Central menjelaskan crawling dan indexing sebagai proses berkelanjutan, bukan switch on/off instan.
Lihat overview Google crawlers bila Anda perlu memverifikasi perilaku resmi Googlebot.
Google dapat mempertahankan URL yang sudah dikenal sementara. Timeline deindex tidak universal. Tidak ada angka hari baku tanpa sumber resmi.
Checklist audit Cloudflare untuk SEO
- Buka Security → Configure AI bot policies (atau label terbaru di docs) dan pastikan Search = Allow bila Anda bergantung pada Google organik.
- Verifikasi Training: gunakan Disallow AI Training bila itu tujuan bisnis; hindari Block kecuali Anda sadar Search ikut terputus.
- Audit WAF custom rules, Bot Fight Mode, rate limit, dan challenge—Googlebot verified tetap bisa terkena rule salah.
- Cek robots.txt di origin; preferensi robots berbeda dari enforcement edge Cloudflare.
- Di Security Events / bot analytics (sesuai plan), cari request Googlebot yang Cloudflare tolak atau challenge.
- Validasi identitas Googlebot lewat reverse DNS dan rentang IP resmi Google—jangan whitelist hanya User-Agent string karena bisa di-spoof.
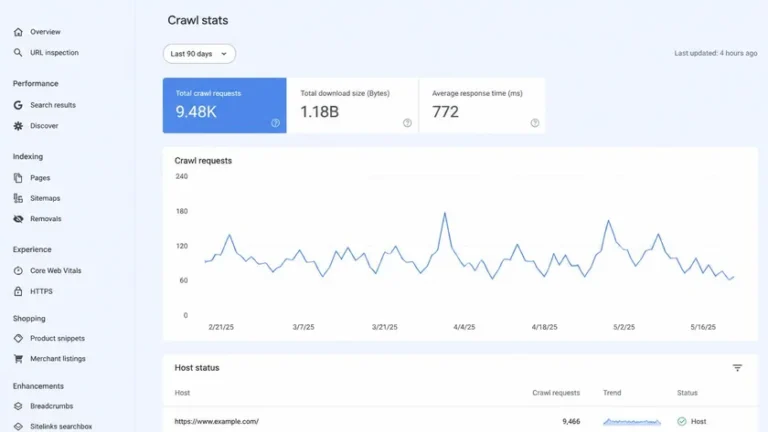
- Pantau Crawl Stats dan URL Inspection di Search Console; fluktuasi satu hari belum otomatis berarti disaster.
Setelah mengubah policy, tunggu beberapa siklus crawl sebelum menilai dampak impression. Kemudian bandingkan log Cloudflare dengan GSC—kombinasi keduanya memberi sinyal lebih kuat daripada spekulasi ranking.
Website yang pernah kena spam bot atau backdoor perlu audit keamanan paralel. Lihat panduan bagaimana website bisa diretas agar rule anti-bot tidak menutupi celah origin yang masih terbuka.
Implikasi bisnis dan konteks AI Search
Sebaliknya, menolak AI training bukan sinyal ranking positif. Mengizinkannya pun tidak menjamin posisi SERP naik. Cloudflare controls adalah granularitas hak konten dan traffic, terpisah dari Core Web Vitals atau on-page SEO.
Publisher menempatkan terpisah nilai discovery Search, hak training, akses agent, dan lisensi konten. Prince membingkai «give-to-get» lama—Google crawl, publisher dapat referral—sebagai keseimbangan yang berubah di era AI. Walau menarik, itu framing ekonomi wawancara, bukan kontrak hukum universal dengan Google.
Untuk visibilitas di ekosistem agen AI, struktur situs yang machine-readable tetap relevan terpisah dari toggle Cloudflare. Lihat SEO untuk AI Agent bila tim Anda menyiapkan konten untuk parser otomatis.
Traffic organik tetap butuh strategi jangka panjang di luar firewall bot. Perbandingan iklan PPC vs SEO membantu stakeholder UMKM Indonesia menempatkan anggaran saat referral Search fluktuatif.
Menurut kami, panik massal «ranking hancur besok» tidak sehat. Yang wajar adalah audit tenang setelah berita viral.
Tim CodeF rutin mengecek bot policy dan crawlability saat maintenance website klien. Stack WordPress di belakang Cloudflare sering kena block AI generik tanpa membaca label mixed-use.