Microsoft DevRel memublikasikan Agent Experience (AX) Practitioner Playbook pada 9 Oktober 2026. Playbook itu metode resmi evaluasi AI coding agent terhadap teknologi Anda: mengukur apa yang agent lakukan, mendiagnosis penyebab kesalahan, lalu memperbaiki sumber yang memengaruhi perilaku agent. PDF-nya ada di aka.ms/ax-playbook dan merangkum pembelajaran dari ratusan sesi agent yang tim DevRel jalankan.
Waldek Mastykarz, Principal Developer Advocate, menulis artikel primer di Microsoft for Developers. Microsoft menekankan output agent kerap terlihat masuk akal dan bisa compile. Namun agent bisa memakai versi SDK salah, pola autentikasi deprecated, atau setup yang product team tidak rekomendasikan. Itu bukan «halusinasi» acak; sinyalnya ada di training data dan permukaan teknologi yang agent temukan.
Bagi tim WordPress, Laravel, atau maintainer plugin di Indonesia, relevansinya jelas. Developer makin sering menilai stack dari hasil agent, bukan hanya dari docs manusia. Menunggu model lebih pintar saja, kata Microsoft, bukan strategi. Yang bisa Anda kendalikan: docs, MCP tools, skills, plugins, instructions, CLI, dan API. Playbook tidak mengikat satu platform evaluasi—tim bisa memakai evaluator internal selama kriteria dan gate eksekusi terpenuhi.
Agent Experience dan Masalah Kode yang Compile
Agent Experience (AX) melengkapi developer experience tradisional. Selain ergonomi docs dan SDK untuk manusia, AX menilai bagaimana agent menemukan teknologi, memilih versi atau pola, memuat extension, memanggil tool, dan menerapkan instruksi. Target akhirnya: implementasi benar-benar runnable. Microsoft DevRel sejak musim gugur 2025 mengukur perilaku agent pada Azure, Cosmos DB, SharePoint Framework (SPFx), dan ekstensi Microsoft 365 Copilot. Prompt-nya meniru kasus developer nyata.
Framing Microsoft menolak shortcut «AI sering salah». Agent dapat mengikuti informasi training atau sumber yang outdated. Evaluasi naif pun bisa menipu: skor sempurna untuk kode yang tidak pernah compile, atau cek «used Platform X» yang lulus meski platform itu tidak benar-benar dipakai. Karena itu evaluasi AI coding agent perlu criteria bermakna dan verification gates. Anda juga perlu bukti implementasi benar-benar jalan—dependency terpasang, build sukses, tes jalan, app start, platform yang dimaksud benar-benar dipakai, pola auth masih current.
Evaluasi Coding Agent: Readout, Trajectory, dan Perbaiki Sumber
Playbook memisahkan readout (apa yang gagal) dari trajectory (mengapa agent sampai ke situ). Extension yang tidak pernah load, load tetapi tidak pernah dipanggil, atau dipanggil tetapi diterapkan salah mengarah ke perbaikan berbeda. Microsoft menyebut sembilan pola kegagalan berulang lintas teknologi. Daftar lengkap dan terminologi exact ada di PDF playbook—redaksi berita ini tidak mengarang nama sembilan pattern tersebut.
Menulis criteria adalah langkah di mana keahlian domain jadi terukur; Microsoft menandai itu sebagai bagian tersulit. Criteria baik mengukur hal yang benar-benar penting. Judge harus menilainya konsisten, tim harus kalibrasi sebelum memercayai skor, lalu version-kan criteria saat produk berubah. Tim product, SDK, atau maintainer docs—bukan model semata—tetap yang mendefinisikan «benar» untuk stack mereka.
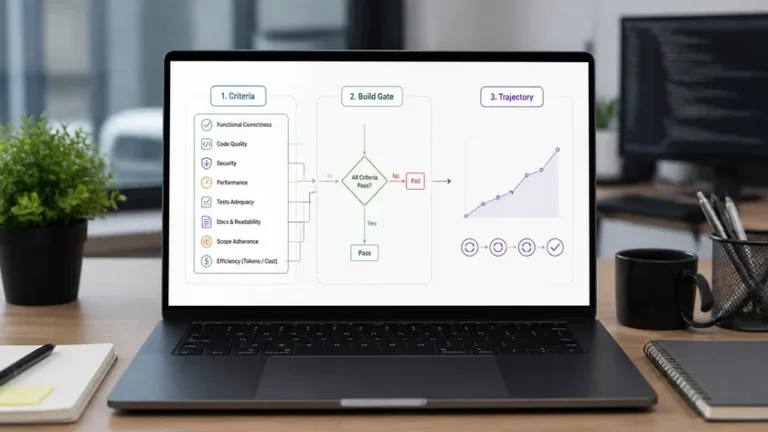
Alur yang Microsoft promosikan: reproduksi skenario, evaluasi, inspeksi trajectory, identifikasi sumber, update docs/MCP/skill/plugin/instruction/API/CLI, evaluasi ulang, verifikasi perbaikan. Setiap usulan fix sebaiknya uji sebagai hipotesis sebelum rilis. Contoh hipotesis: docs menonjolkan pola auth current sehingga agent berhenti memilih pola deprecated. Lalu jalankan evaluasi yang sama untuk membandingkan bukti.
Evaluasi internal Microsoft menghasilkan puluhan perbaikan yang benar-benar ship, termasuk 46 improvements pada Azure Cosmos DB Agent Kit. Angka itu jumlah perbaikan, bukan persentase benchmark performa. Skenario upgrade proyek SPFx di playbook dijalankan end-to-end sebagai contoh nyata.
MCP, Skills, Plugin, dan Docs sebagai Permukaan Produk
AX menempatkan dokumentasi, MCP server, skill file, plugin, set instruksi, CLI, dan API sebagai permukaan setara prompt user. MCP bisa memberi tool terstruktur dan konteks. Tetapi kegagalan tetap mungkin: tool tidak load, tidak terpilih, schema ambigu, output tidak berguna, atau konflik instruksi. Skill memberi panduan task-specific; tim tetap harus buktikan efektivitasnya lewat evaluasi, bukan mengasumsikannya.
Kajian CodeF: maintainer open source dan tim produk WordPress sebaiknya memperlakukan docs terindeks lama, contoh versi usang, dan file skill di repositori sebagai sumber error agent. Pola ini mirip isu vibe coding yang menghasilkan kode tanpa fondasi SEO, hanya di sisi SDK dan autentikasi. Pola auth deprecated bukan masalah sintaks semata; itu risiko keamanan dan reliabilitas produksi.
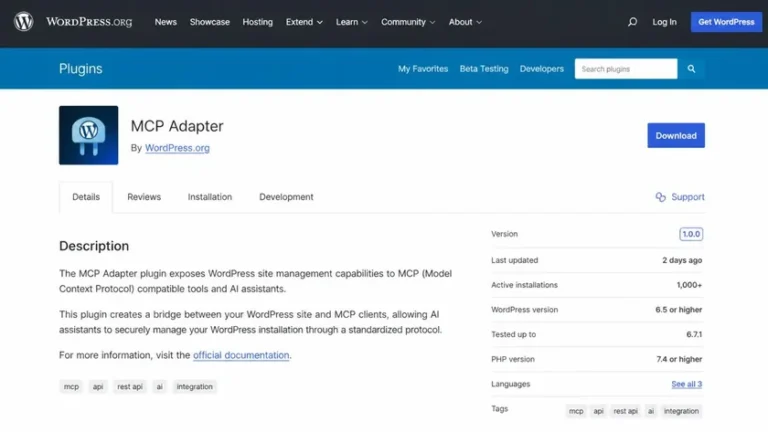
Untuk ekosistem WordPress, rilis MCP Adapter resmi di WordPress.org menambah permukaan MCP baru. Evaluasi ala AX relevan untuk mengecek apakah agent benar-benar memakai Abilities API atau server default, bukan hanya «mengetik» kode plugin yang compile. Pembaca yang membandingkan alur kerja editor AI-first bisa melihat konteks di artikel VSCode vs Cursor. Tim web yang ingin docs readable untuk mesin dapat melanjutkan ke panduan SEO untuk AI agent.
AX Practitioner Skill dan Batas Metode
Bersama PDF, Microsoft merilis AX Practitioner skill untuk dipasang di coding agent. Skill itu membantu wording criteria atau review skenario terhadap standar playbook. Skill hanya menjawab dari isi playbook. Bila pertanyaan di luar scope, skill memberi tahu dan meminta izin sebelum memakai sumber lain. Microsoft melaporkan evaluasi internal: rata-rata skor 95% pada 330 pertanyaan terhadap konten playbook. Metrik itu khusus skill companion, bukan klaim akurasi universal untuk semua pekerjaan AX.
Playbook lahir dari pekerjaan DevRel Microsoft, tetapi sumber mengatakan practitioner dapat menerapkan metode pada teknologi non-Microsoft. Audiens utama: pembuat SDK, API, layanan, CLI, MCP server, skill, plugin, instruction set, dan dokumentasinya. Developer advocate pun relevan bila mereka membawa skenario evaluasi plus bukti ke tim pemilik produk.
AX bukan benchmark Claude versus GPT dan bukan jaminan agent selalu benar. AX juga bukan pengganti domain expert: menulis criteria tetap langkah tersulit. Microsoft sebut eksplisit jebakan «membiarkan model menulis seluruh criteria untuk dirinya sendiri».
Ke depan, pantau apakah tim produk di luar Azure stack mengadopsi gate serupa. Perhatikan juga seberapa cepat tim version-kan docs dan skill di repositori WordPress/Laravel saat SDK berubah, serta apakah companion skill AX Practitioner diperbarui seiring revisi playbook. Unduh playbook dari link primer Microsoft bila Anda ingin checklist kualitas evaluasi sebelum menjalankan sesi agent pada skenario produksi nyata.