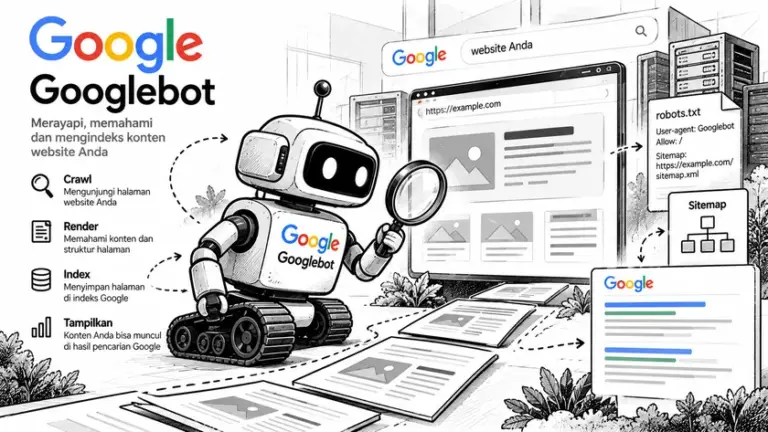
Media meliput wawancara Odys Podcast pada 30 Oktober 2026; Gary Illyes dari Google menilai kebutuhan konten untuk training AI memperbesar insentif bot menyamar sebagai crawler resmi. Itu penilaian narasumber, bukan bukti studi kausal Google. Masalah operasional untuk pemilik situs tetap sama: string Googlebot pada user-agent bukan bukti keaslian crawler, sehingga praktik bot palsu Googlebot bisa lolos bila Anda hanya memfilter nama agent.
Video wawancara menjadi sumber utama kutipan Illyes. Ringkasan Search Engine Roundtable membantu navigasi topik, tetapi cocokkan klaim material dengan rekaman sebelum publikasi final.
Mengapa user-agent tidak cukup
User-agent adalah string yang client kirim dan mudah ditiru. Allowlist hanya berdasarkan teks dapat memberi crawler palsu akses yang Anda maksudkan untuk Googlebot sungguhan. Framing yang tepat bukan serangan yang mengaku Googlebot, melainkan pihak lain menyamar sebagai Googlebot.
Illyes juga membahas deteksi di CDN dan firewall sebagai lapisan yang membaik namun tidak sempurna. Artikel ini tidak mengklaim tingkat kegagalan numerik karena sumber wawancara tidak memberi angka prevalensi global.
Verifikasi bot palsu Googlebot versus crawler resmi
Google menerbitkan prosedur Verify requests from Google crawlers and fetchers; Google memperbarui halaman itu terakhir 20 Maret 2026. Alur manual: ambil IP dari log, lakukan reverse DNS, pastikan hostname berada pada domain Google yang relevan, lalu forward DNS hostname itu dan cocokkan IP awal.
Untuk skala besar, dokumentasi mengarahkan pencocokan terhadap file JSON rentang IP resmi (common crawlers, special-case crawlers, user-triggered fetchers). Jangan menempel daftar IP statis di artikel berita karena rentang dapat berubah. Halaman What Is Googlebot menjelaskan perilaku crawler umum, terpisah dari autentikasi request.
robots.txt, WAF, dan resource
Common crawlers Google mengikuti robots.txt, tetapi bot jahat dapat mengabaikannya. File robots adalah arahan crawling, bukan mekanisme keamanan atau login. Keputusan allow atau block sebaiknya memakai asal IP terverifikasi, pola request, kebutuhan bisnis, dan beban server.
Bot agresif, baik jahat maupun salah konfigurasi, dapat menghabiskan bandwidth meski tidak berniat merusak ranking. Jangan menghubungkan lonjakan bot langsung ke penurunan posisi tanpa data crawl, log server, dan Search Console.
Langkah kontrol setelah asal bot jelas
Setelah Anda memahami verifikasi DNS, keputusan konfigurasi edge lebih aman. Tutorial Cloudflare Bisa Blokir Googlebot? Bedakan AI Training dan Search membahas perbedaan crawler Search versus AI training tanpa menggantikan prosedur verifikasi Google.
Kebijakan block crawler AI secara umum muncul di artikel Haruskah Block Bot AI: Perlu atau Tidak? Gagasan Web Bot Auth atau skor reputasi bot bisa Anda anggap eksperimen masa depan, bukan standar wajib hari ini.
Tiga kategori crawler Google
Dokumentasi verifikasi Google membedakan common crawlers seperti Googlebot, special-case crawlers seperti AdsBot dengan aturan robots yang bisa berbeda, dan user-triggered fetchers yang pengguna picu. Masing-masing punya pola reverse DNS dan file JSON IP sendiri. Kesalahan klasifikasi kategori dapat membuat rule firewall memblokir fetcher sah atau membuka akses ke bot palsu.
Monitoring log yang praktis
Tim kecil bisa memulai dari sample log access server: urutkan IP dengan user-agent Googlebot, verifikasi sampel dengan perintah host, lalu bandingkan dengan rentang JSON. CDN seperti Cloudflare menambahkan header dan skor bot yang membantu, tetapi tetap perlu cross-check DNS bila klaim keaslian Google jadi dasar keputusan bisnis.
Artikel ini bukan berita update ranking atau algoritme Search. Liputan Illyes fokus keaslian request dan tekanan scraping, bukan sinyal indeks baru.
Kesalahan allowlist yang sering
Rule firewall yang mengizinkan semua request ber-user-agent Googlebot tanpa verifikasi DNS effectively memberi crawler palsu jalur yang sama dengan bot resmi. Sebaliknya, rule yang memblokir rentang IP tanpa cek hostname dapat memotong fetcher Google yang sah. Keduanya mahal untuk SEO dan keamanan.
Untuk situs WordPress dengan lonjakan traffic, artikel Website WordPress Diserbu Bot? memberi respons operasional setelah Anda memisahkan bot teridentifikasi dari bot tidak dikenal.
Batas wawancara podcast
Odys Podcast bukan dokumen kebijakan Google. Kutipan Illyes tentang AI memperparah impersonation tetap opini ahli, bukan bukti ukuran bot palsu global. Google Search Central tidak merilis bulletin terpisah pada tanggal yang sama untuk topik identik menurut sumber sekunder untuk riset artikel ini.
Integrasi dengan analytics
Bila masalah utama adalah traffic bot palsu yang mengotori GA4, filter di GTM dan Cloudflare bisa melengkapi verifikasi DNS. Tutorial Cara Menyaring Traffic Bot di GA4 dengan GTM dan Cloudflare fokus measurement, bukan autentikasi crawler Google.
Keputusan block permanen versus rate limit perlu alasan bisnis tertulis. Blokir crawler resmi Google by mistake dapat menurunkan cakupan indeks, sementara izinkan bot palsu hanya membuang resource server.
