Backup website yang andal punya setidaknya satu salinan penting di luar failure domain provider utama. Snapshot di akun cloud yang sama saja belum cukup. Insiden ransomware IDCF Cloud (IDC Frontier) Oktober 2026 mempertegas hal itu. Pemulihan di zone terdampak mengandalkan backup milik pelanggan.
Tim operasional di Indonesia sering menganggap VPS atau managed hosting sudah “aman” karena ada fitur cadangan otomatis. Gangguan skala provider tetap mungkin—meski jarang sebesar kasus Jepang ini. Jadi pertanyaannya bukan apakah cloud buruk. Yang perlu Anda cek: apakah cadangan masih menempel pada satu vendor, satu region, atau satu kredensial admin.
Highlight
Backup Website di Luar Provider Cloud: Pelajaran dari Kasus Ransomware IDCF Cloud
- IDC Frontier mengonfirmasi ransomware pihak ketiga pada IDCF Cloud East Japan Region 1 sekitar 7 Oktober 2026 pukul 03:40 JST; 495 perusahaan dan pemerintah daerah terdampak gangguan layanan.
- Empat zone (tesla, henry, pascal, joule) mengalami virtual server berhenti dan sulit direstart; IDC Frontier memperkirakan pemulihan data di zone itu sulit menurut pengumuman resmi.
- Hosting cloud ≠ strategi backup: compute dan snapshot opsional tidak menggantikan salinan independen di provider, akun, atau media berbeda.
- Snapshot berguna untuk rollback cepat, tetapi sering berbagi storage, region, atau control plane dengan produksi—bukan lapisan cadangan tunggal.
- Log backup sukses ≠ restore sukses; uji pemulihan berkala (file, database, konfigurasi) wajib memvalidasi RPO dan RTO bisnis Anda.
Insiden Ransomware IDCF Cloud: Fakta Resmi
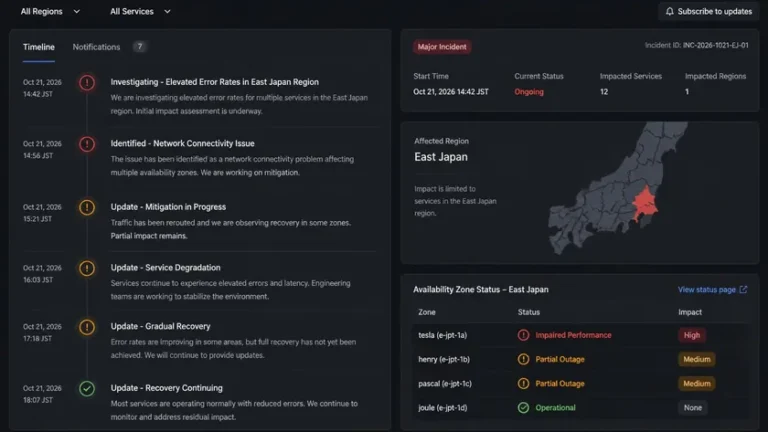
IDC Frontier, operator IDCF Cloud, menerbitkan rangkaian pemberitahuan resmi mulai 7 Oktober 2026. Perusahaan itu menyebut penyebab gangguan sebagai serangan ransomware pihak ketiga. Dampak terfokus pada East Japan Region 1, bukan seluruh footprint IDCF Cloud.
Zone virtual server yang terdampak bernama tesla, henry, pascal, dan joule. Layanan di empat zone itu berhenti; restart tidak tersedia. IDC Frontier memutus jaringan dan menghentikan konsol sistem untuk membatasi penyebaran. Namun region atau zone lain—pada update 8 Oktober—belum menunjukkan akses tidak sah. Pelanggan di area itu tetap harus membuat cadangan sebagai langkah pencegahan.
Angka 495 companies and local governments merujuk organisasi pelanggan yang terkena gangguan layanan. Bukan klaim bahwa 495 situs web hilang seluruhnya. Dampak per pelanggan berbeda. Investigasi masih berjalan saat pengumuman keluar.
Rincian teknis dari pihak penyerang—apakah snapshot internal ikut dihapus, misalnya—belum IDC Frontier konfirmasi sebagai fakta. Yang aman ditulis: ransomware, zone terdampak, layanan lumpuh, dan assessment bahwa pemulihan data di zone tersebut sulit. Sumber primer: pemberitahuan resmi IDC Frontier dan update lanjutan di domain idcf.jp.
Mengapa Pemulihan Mengandalkan Backup Pelanggan
Pada update 8 Oktober 2026, IDC Frontier menyatakan pemulihan data pelanggan di empat zone terdampak sulit. Arah recovery saat itu jelas: pakai backup milik pelanggan sendiri. Lalu bangun ulang di environment berbeda bila perlu.
Kalimat resmi itu bukan drama marketing. Lantaran cadangan yang hanya “menempel” pada ekosistem provider yang sama bisa ikut tidak andal. Insiden bisa menyerang control plane, storage backend, atau akun administratif region yang sama. Pelanggan tanpa salinan eksternal terjepit: menunggu investigasi vendor sambil produksi offline tanpa jalan pulih cepat.
Serangan ransomware pada infrastruktur web bukan teori. Pola serupa muncul saat hardening situs, bukan hanya server cloud. Memahami vektor umum—backdoor, spam SEO, kredensial bocor—membantu Anda mengunci produksi sambil merapikan cadangan. Selanjutnya lihat penjelasan bagaimana website bisa diretas untuk lapisan aplikasi.
Cloud Hosting Bukan Strategi Backup Website
Menaruh website di cloud memberi compute, storage, jaringan, dan fitur opsional seperti snapshot atau backup terkelola. Itu infrastruktur produksi. Notifikasi “backup enabled” di panel belum otomatis memenuhi prinsip ketahanan bila semua objek cadangan masih satu failure domain.
Failure domain adalah kumpulan sistem yang bisa gagal bersama karena satu penyebab. Contohnya: host fisik sama, region sama, akun billing sama, kredensial admin sama, atau backend storage sama. Strategi cadangan kuat memindahkan setidaknya satu salinan keluar dari domain itu.
Provider snapshot tetap berguna—rollback setelah patch gagal, migrasi cepat, restore point-in-time rutin. Menurut kami, menolak snapshot sama sekali sama ekstremnya dengan menganggap snapshot sudah cukup. Masalahnya muncul bila snapshot menjadi satu-satunya lapisan dan insiden vendor membuat lapisan itu tidak terjangkau bersamaan dengan VM produksi.
Snapshot vs Backup dan Prinsip 3-2-1
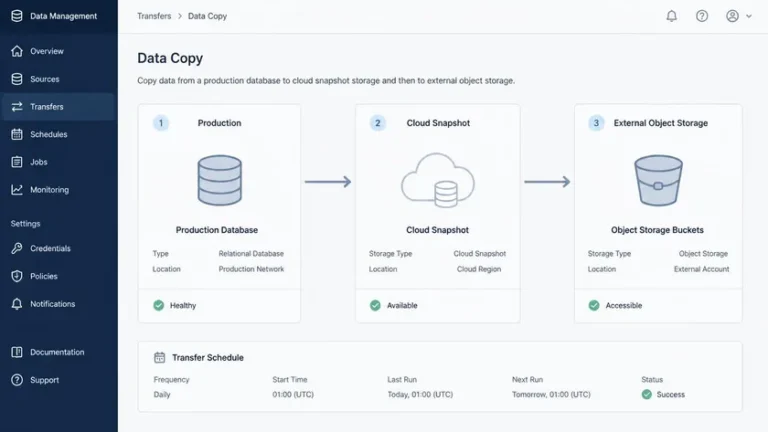
Snapshot biasanya hidup di ekosistem provider yang sama dengan disk produksi. Backup website untuk disaster recovery menambah salinan aplikasi: dump database, arsip uploads, konfigurasi server, metadata DNS. Simpan salinan itu di object storage provider lain, NAS offsite, atau media terpisah dengan kredensial berbeda.
Panduan CISA mengingatkan organisasi mempertahankan beberapa salinan data. Termasuk cadangan offline atau off-site, plus uji restore rutin. Kerangka 3-2-1 (tiga salinan, dua media, satu off-site) bukan jaminan absolut. Tetapi memberi bahasa operasional: produksi, cadangan di cloud A, cadangan independen di cloud B atau storage fisik terpisah.
Offsite dan immutable tidak identik. Offsite hanya berarti lokasi berbeda. Immutable (object lock, retention WORM) membatasi penghapusan atau overwrite selama retensi. Berguna bila admin cloud compromized mencoba membersihkan jejak. Keduanya bisa Anda kombinasikan; namun fitur bernama berbeda tiap vendor.
Komponen Backup WordPress, Laravel, dan VPS
Stack menentukan inventaris cadangan. WordPress butuh database, wp-content/uploads, theme/plugin kustom, MU-plugin, dan file konfigurasi server bila Anda mengubah Nginx atau PHP-FPM. Anda bisa install ulang core WordPress. Konten dan kustomisasi tidak selalu bisa Anda bangun ulang dari nol.
Laravel: kode sering ada di Git, tetapi Git bukan cadangan database. Anda tetap perlu dump DB, folder storage/app uploads, state queue bila kritis, plus .env lewat mekanisme rahasia terpisah—jangan menaruh secret plain di arsip zip publik. Perbandingan stack bisnis membantu memilih prioritas cadangan; baca WordPress vs Laravel bila Anda masih di fase memilih platform.
Di VPS atau panel seperti aaPanel, jangan andalkan folder backup lokal di disk yang sama dengan produksi. Berikut lapisan yang masuk akal: snapshot provider sebelum update besar; backup aplikasi/DB terjadwal ke object storage eksternal; retensi multi-generasi; verifikasi restore triwulanan.
WooCommerce atau toko online menambah tekanan RPO: order, stok, dan data pelanggan berubah menit demi menit. Frekuensi harian bisa kurang bila volume transaksi tinggi—sesuaikan dengan toleransi kehilangan data bisnis, bukan jadwal “default hosting”.
RPO, RTO, dan Restore Test
RPO (Recovery Point Objective) = seberapa banyak data terbaru yang masih bisa Anda rela hilang. Backup hourly vs daily langsung memengaruhi angka itu. RTO (Recovery Time Objective) = seberapa cepat layanan harus online lagi—termasuk waktu unduh arsip, import DB, dan switch DNS.
NIST menekankan tim harus membuat cadangan berkala, mengujinya, dan memakainya dalam latihan recovery (panduan praktis NIST terkait ransomware). Langkah restore test yang kami anjurkan: environment terisolasi; restore file, DB, config; start aplikasi; cek login, halaman, API; catat waktu dan gap data.
Generasi cadangan lama penting: backup terbaru bisa sudah terinfeksi file berbahaya atau config compromized. Simpan beberapa generasi agar Anda bisa memilih last known good. Monitor juga ukuran arsip—penurunan drastis tanpa penjelasan sering indikasi backup kosong atau gagal diam-diam.
Checklist Backup Website Hari Ini
Jawab jujur sebelum insiden berikutnya—skala kecil di hosting lokal pun prinsipnya sama:
- Jika provider utama offline hari ini, apakah cadangan masih bisa diunduh dari akun lain?
- Apakah DB dan uploads keduanya masuk arsip, plus DNS dan catatan sertifikat?
- Apakah kredensial backup terpisah dari admin produksi, dengan MFA bila tersedia?
- Kapan terakhir Anda restore test—notifikasi cron sukses saja?
- Berapa RPO/RTO yang disepakati tim bisnis, bukan hanya tim teknis?
Runbook disaster recovery—siapa memutus mode darurat, urutan restore, switch DNS—simpan salinan di luar cloud account produksi. Dokumentasi infrastruktur (Terraform, Ansible, skrip deploy) membantu rebuild server. Namun dump database dan media pengguna tetap wajib.
Bila tim internal tidak sempat merapikan cadangan, retensi, dan drill restore, layanan maintenance website bisa membantu audit arsitektur cadangan. Tanggung jawab pemilik data tetap pada Anda. Sejak 2009. Apakah arsip benar-benar masuk storage eksternal, bukan hanya notifikasi hijau di dashboard.
Akhirnya, insiden IDCF Cloud mengingatkan: provider besar pun bisa kena ransomware. Yang Anda kontrol: apakah masih punya salinan di luar provider itu, dan apakah salinan itu pernah Anda pulihkan dalam uji coba.